Saiu o Sonnet 5.5: a dois pontos do Opus, pela metade do preço.
O segundo modelo da família 5.5 é mais de 30% mais rápido, custa até 30% menos por tarefa que o Sonnet 5 e fica colado no Opus 5.5 em quase todo teste. Tudo que apareceu no lançamento, as demonstrações lado a lado e um guia mastigado de quando usar cada modelo da família 5.5.
A Anthropic lançou hoje o Claude Sonnet 5.5, o segundo modelo da família 5.5. Seis dias depois do Opus 5.5.
E o número que mais me chamou atenção na página foi esse: num teste de trabalho real em 44 profissões, o Sonnet 5.5 ficou a dois pontos do Opus 5.5. Custando metade por token.
Só que a própria Anthropic avisa, na mesma página, que o Opus continua claramente mais forte no trabalho complexo. Então essa newsletter tem duas partes: tudo que apareceu no lançamento, explicado em palavras simples, e quando usar cada modelo da família 5.5, do Opus ao Haiku que vem aí. Os prints estão traduzidos e as demonstrações foram gravadas da página oficial.
O que é o Sonnet 5.5
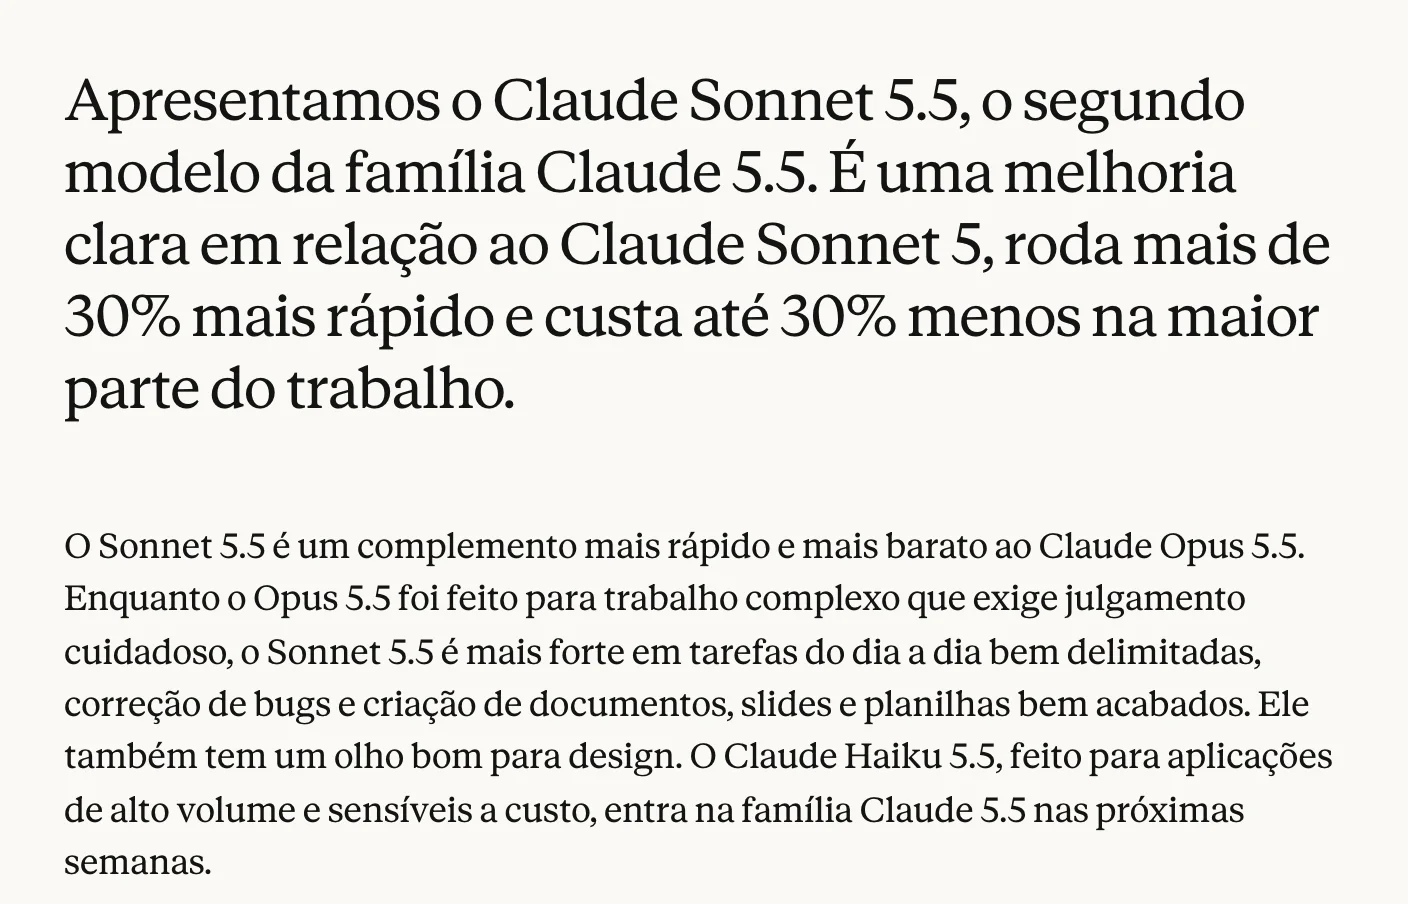
A Anthropic posiciona o Sonnet como o parceiro mais rápido e mais barato do Opus. O Opus 5.5 é o do trabalho complexo, que exige julgamento cuidadoso. O Sonnet 5.5 é o mais forte em tarefa do dia a dia bem delimitada, em correção de bug e em documento, slide e planilha bem acabados. E eles fazem questão de dizer que ele tem um olho bom pra design.
E o terceiro da família, o Haiku 5.5, pensado pra alto volume e custo baixo, chega nas próximas semanas.
O que melhorou em relação ao Sonnet 5, nas cinco frentes que a página lista:
- Desempenho. No Terminal-Bench 4.0, um teste de programação com agente, ele fez 70,6%. O Sonnet 5 fazia 10,3%. E ele é o primeiro Sonnet a zerar o Pokémon Red jogando só a partir de prints da tela.
- Colaboração. Igual ao Opus 5.5, ele escreve de um jeito mais claro que a geração anterior. Quem testou antes disse que ele é um parceiro melhor de trabalho que o Sonnet 5, e a velocidade ajuda em quem itera rápido.
- Custo. O preço por token é o mesmo do Sonnet 5, mas ele gasta bem menos token pra fazer a mesma coisa. No teste deles, sai até 30% mais barato por tarefa.
- Velocidade. Gera resposta mais de 30% mais rápido que o Sonnet 5. É o Sonnet mais rápido que eles já fizeram.
- Segurança. Empata ou melhora em relação ao Sonnet 5 na maioria das medidas, e é o primeiro Sonnet a sair com as travas de cibersegurança dos modelos mais fortes.
Os números lado a lado com o Opus 5.5
A Anthropic publicou a tabela comparando o Sonnet 5.5 com o Sonnet 5, o Opus 5.5 e o GPT-6 Sol:
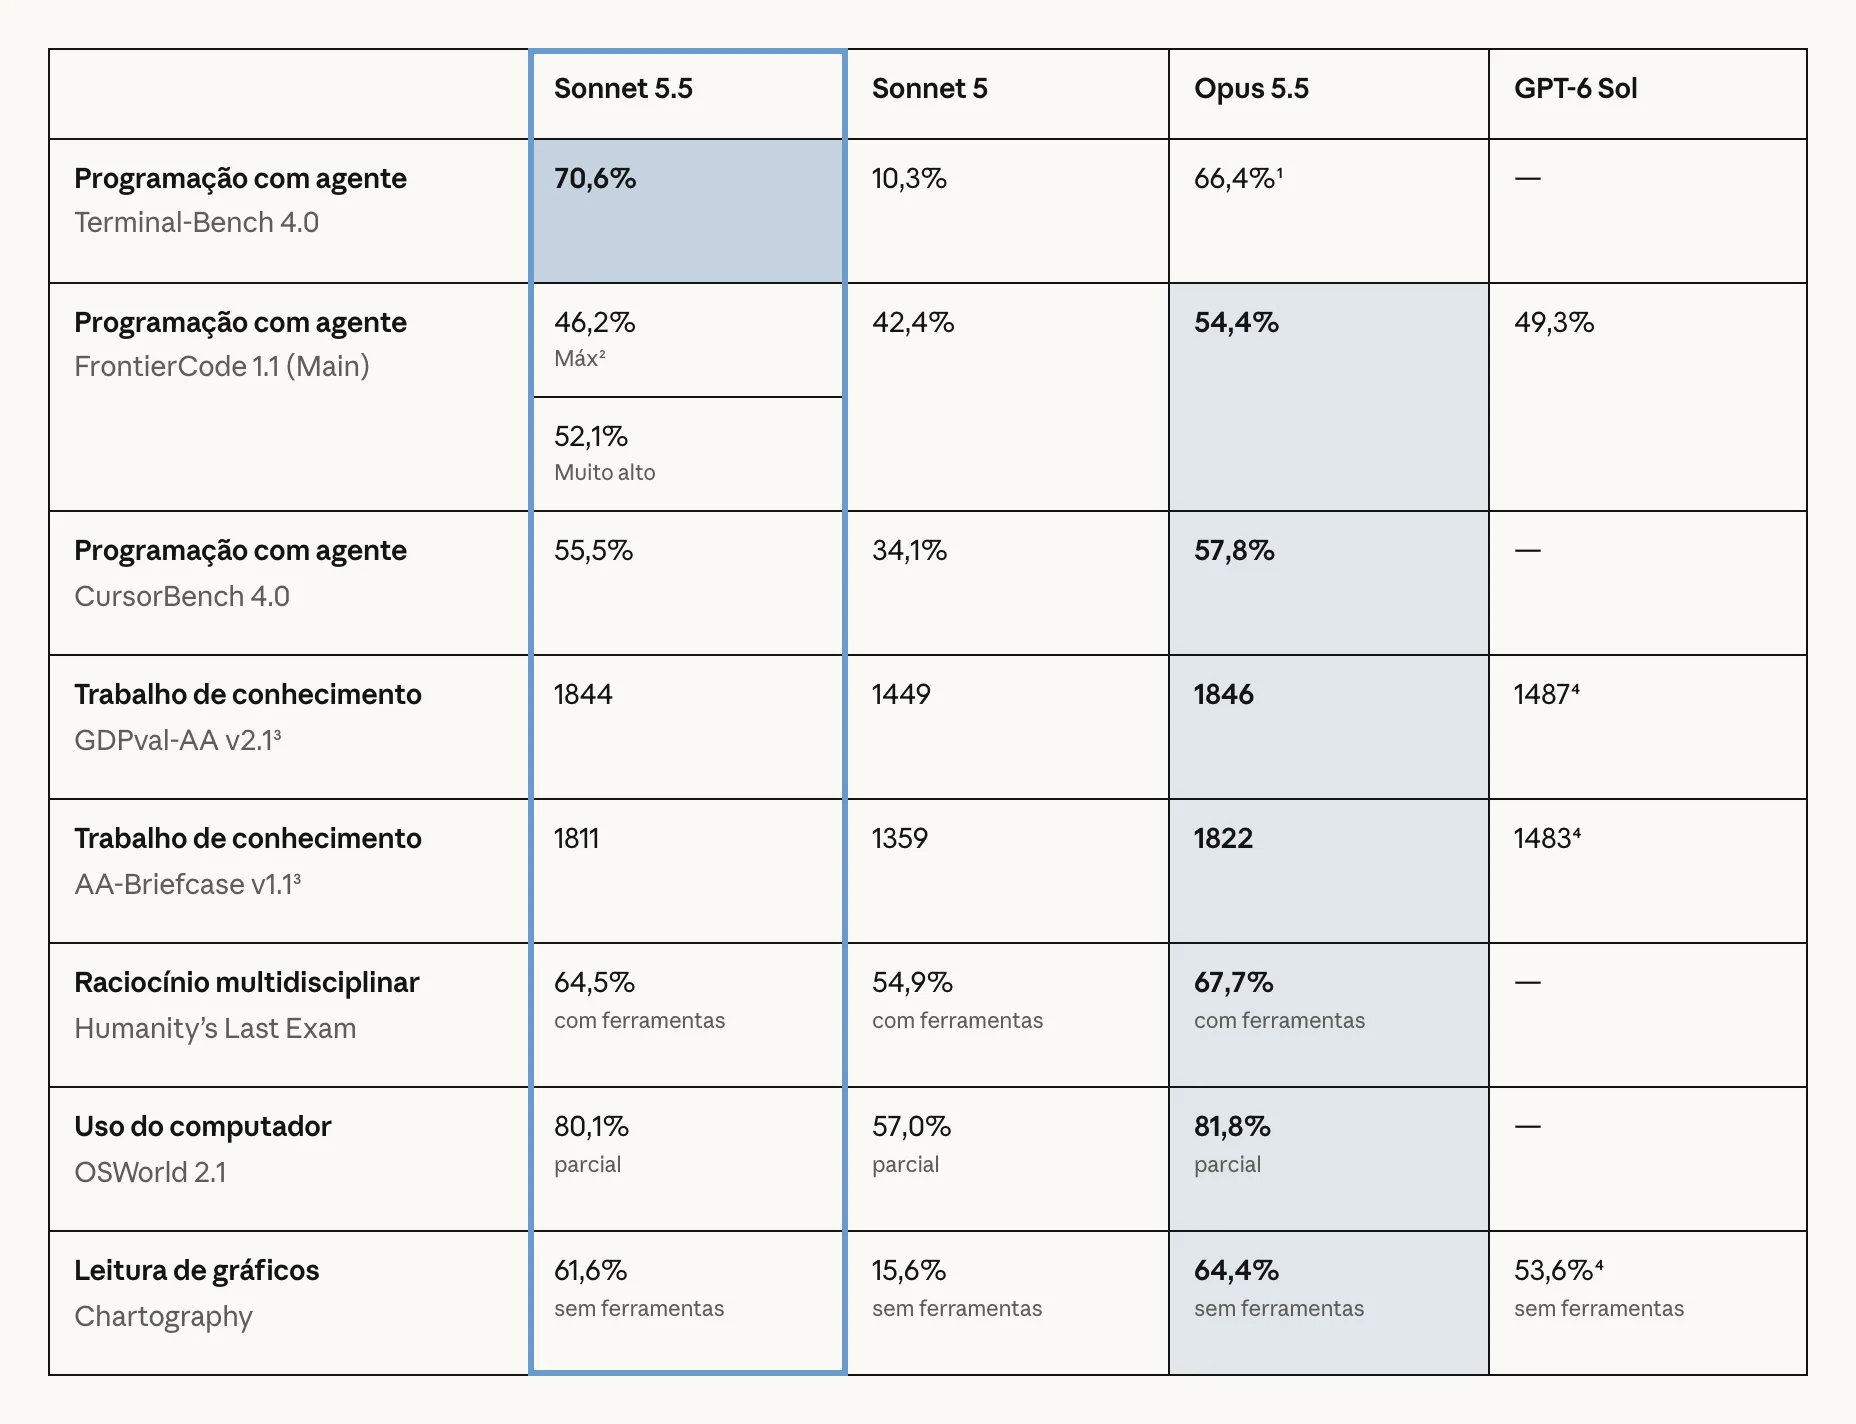
Traduzindo cada linha pro que ela mede:
- Programação no terminal (Terminal-Bench 4.0): Sonnet 5.5 70,6% · Opus 5.5 66,4% · Sonnet 5 10,3%. Aqui o Sonnet passa o Opus, e o 66,4% é a melhor nota do Opus, no esforço muito alto.
- Código que dá pra aprovar sem ninguém mexer (FrontierCode 1.1): Sonnet 5.5 52,1% no esforço muito alto e 46,2% no máximo · Opus 5.5 54,4% · GPT-6 Sol 49,3% · Sonnet 5 42,4%
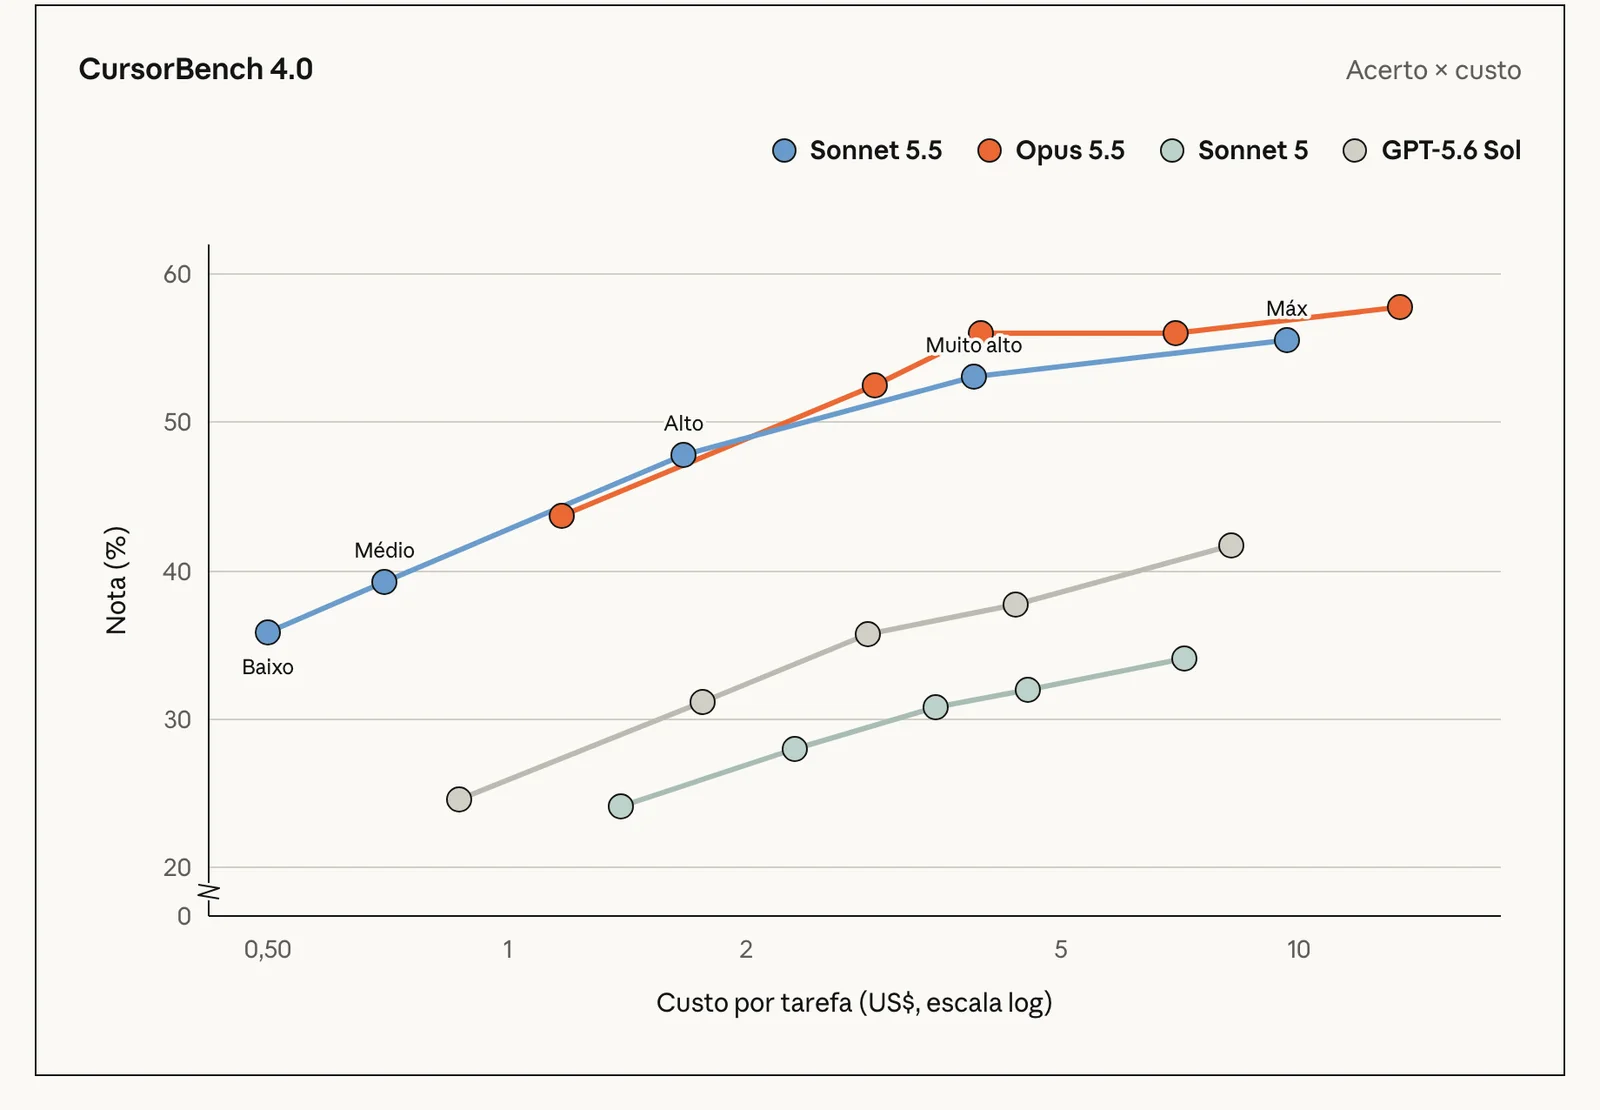
- Programação em sessões reais do Cursor (CursorBench 4.0): Sonnet 5.5 55,5% · Opus 5.5 57,8% · Sonnet 5 34,1%
- Trabalho real em 44 profissões (GDPval-AA v2.1): Sonnet 5.5 1844 · Opus 5.5 1846 · GPT-6 Sol 1487 · Sonnet 5 1449
- Trabalho de conhecimento longo (AA-Briefcase v1.1): Sonnet 5.5 1811 · Opus 5.5 1822 · GPT-6 Sol 1483 · Sonnet 5 1359
- Raciocínio em várias áreas (Humanity's Last Exam, com ferramentas): Sonnet 5.5 64,5% · Opus 5.5 67,7% · Sonnet 5 54,9%
- Uso do computador (OSWorld 2.1): Sonnet 5.5 80,1% · Opus 5.5 81,8% · Sonnet 5 57,0%
- Leitura de gráficos (Chartography, sem ferramentas): Sonnet 5.5 61,6% · Opus 5.5 64,4% · GPT-6 Sol 53,6% · Sonnet 5 15,6%
Repara no padrão. O Opus fica na frente em quase tudo, mas por muito pouco, e no terminal o Sonnet passa. O salto de verdade é contra o Sonnet 5: no terminal saiu de 10 pra 70, na leitura de gráficos de 15 pra 61, e no trabalho real em várias profissões subiu uns 400 pontos.
Tem um detalhe curioso no FrontierCode. O Sonnet 5.5 foi pior no esforço máximo do que no muito alto. A nota de rodapé explica: no máximo, ele passou a rodar a revisão de código do Claude Code, que divide o trabalho entre vários subagentes, e em dois casos isso estourou o tempo ou fez mudança além do que a tarefa pedia. E esse teste penaliza mudança fora do escopo, mesmo quando ela é boa.
E logo depois da tabela vem o aviso que importa pra decidir qual usar:
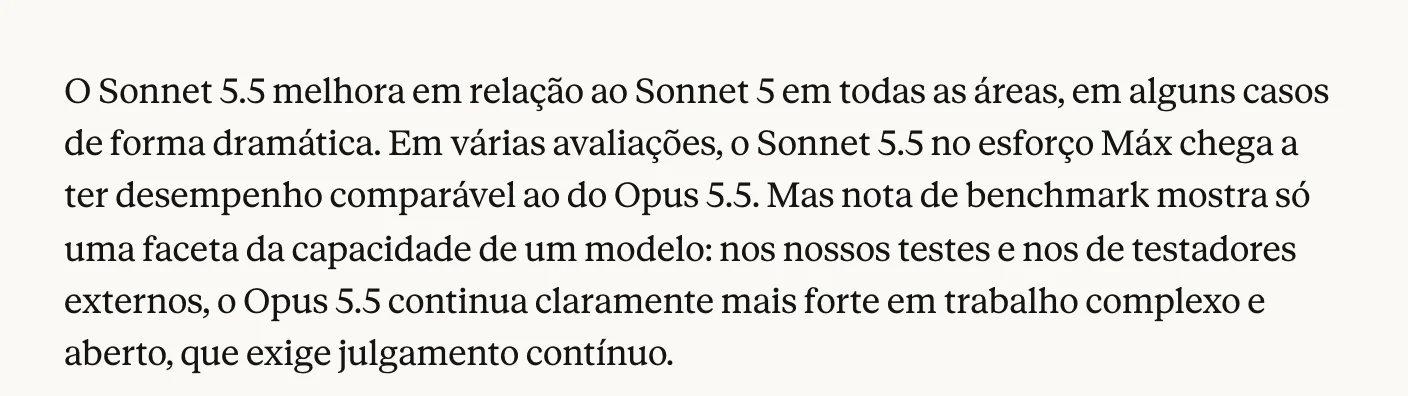
Ou seja: em vários testes o Sonnet no esforço máximo chega perto do Opus, mas, no uso deles e no de quem testou antes, o Opus continua claramente mais forte em trabalho complexo e aberto, aquele que pede julgamento o tempo todo.
Os gráficos que respondem quando usar cada um
Essa é a parte da página que eu mais recomendo olhar com calma. Cada gráfico coloca a nota do modelo de um lado e o custo por tarefa do outro, em cada nível de esforço. Quanto mais pro alto e pra esquerda está o ponto, mais capacidade por dólar.
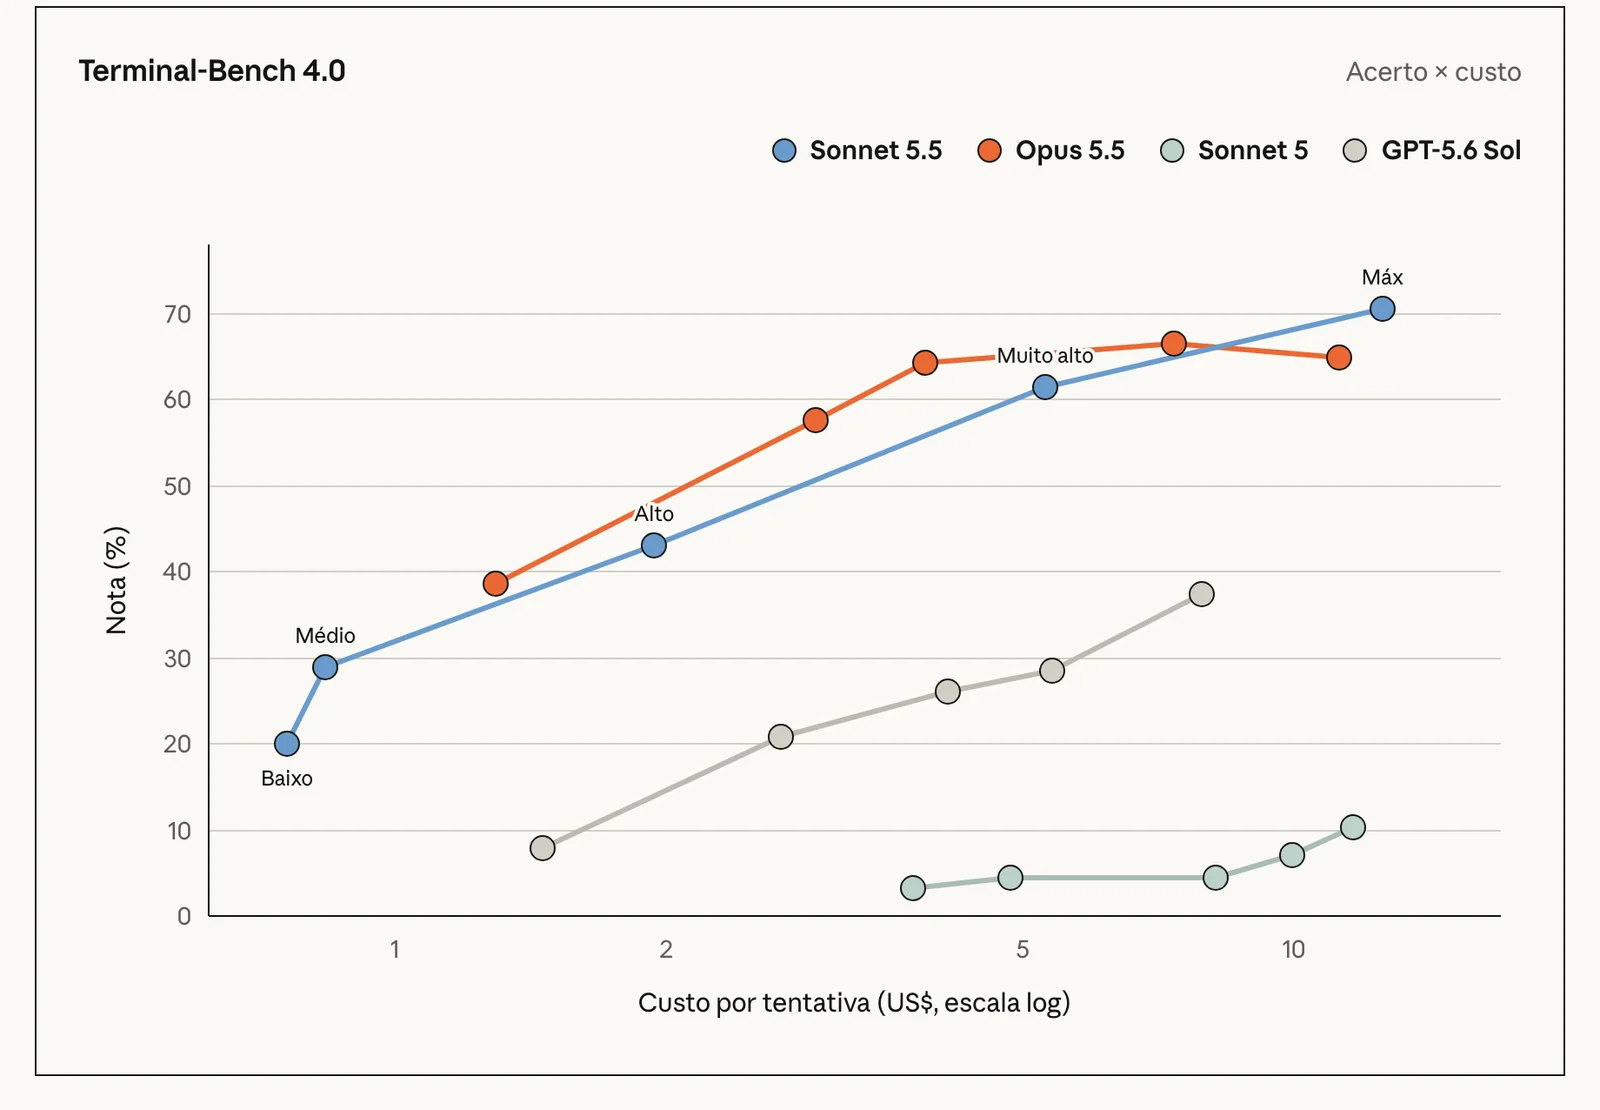
No esforço Médio, que é o padrão nos apps do Claude, o Sonnet 5.5 passa com folga a melhor nota que o Sonnet 5 conseguia, custando menos de um décimo por tarefa. A OpenAI não publicou o GPT-6 Sol nesse teste, então no gráfico aparece o GPT-5.6 Sol.
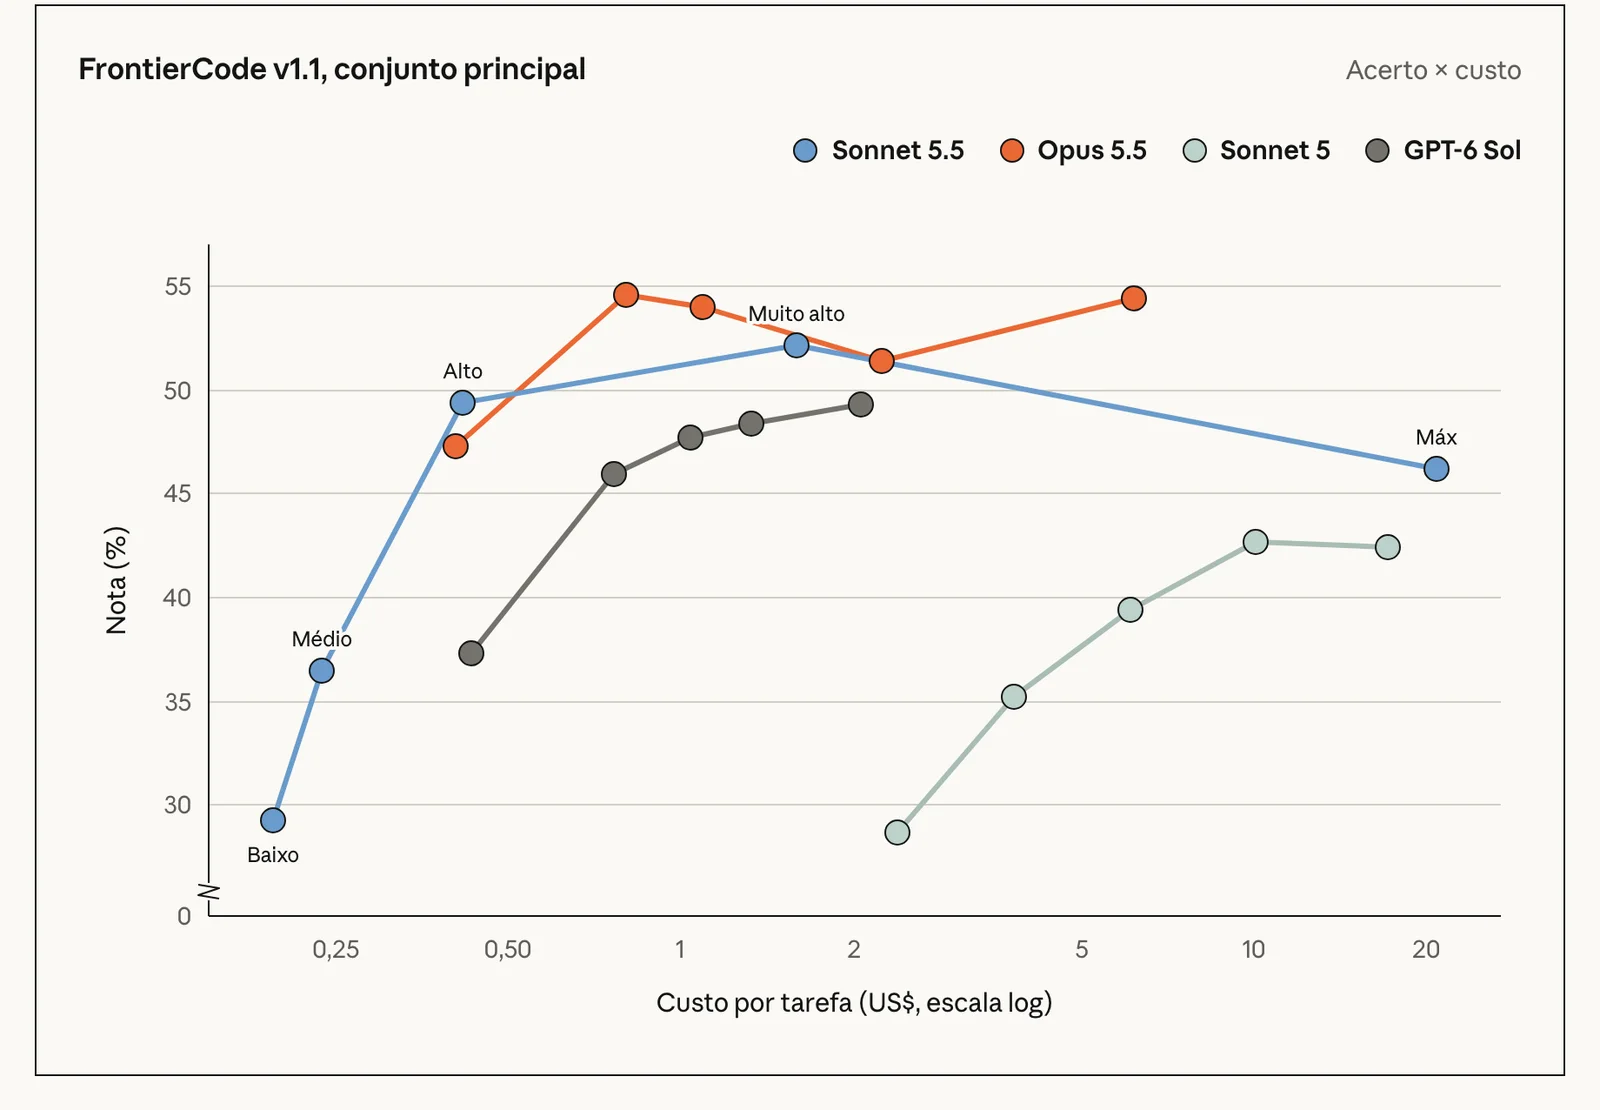
No FrontierCode, no esforço Alto, ele faz 10 pontos a mais que o Sonnet 5 no mesmo esforço, custando mais ou menos um quinze avos por tarefa. E dá pra ver a queda no esforço máximo que eu comentei acima.
Falta o resto desta edição
Inscrição única, uma vez só. Libera esta e todas as outras edições, e você recebe as próximas no e-mail assim que entrarem no ar.