Saiu o Opus 5.5. Mais barato, escreve melhor e ainda veio com reset.
O primeiro modelo da família 5.5 chega no nível do Fable 5.1 na maior parte do trabalho, custa 40% menos que o Opus 5 e aumenta o limite no Pro, Max e Team. E o reset que faltou no meu post chegou, pra você guardar e usar quando quiser.
Hoje, 22 de setembro, a Anthropic lançou o Claude Opus 5.5. Eu postei no calor do lançamento e fechei o post reclamando que só faltava uma coisa: o reset.
Algumas horas depois ele veio. E veio melhor do que eu tinha pedido, porque você não é obrigado a usar agora. Dá pra guardar.
Então vamos por partes, que tem bastante coisa boa nesse lançamento e muita gente vai ler só o título. Tudo que está aqui embaixo saiu da página oficial do Opus 5.5, traduzido e em palavras simples.
O que é o Opus 5.5
A primeira frase da página já resume o lançamento:
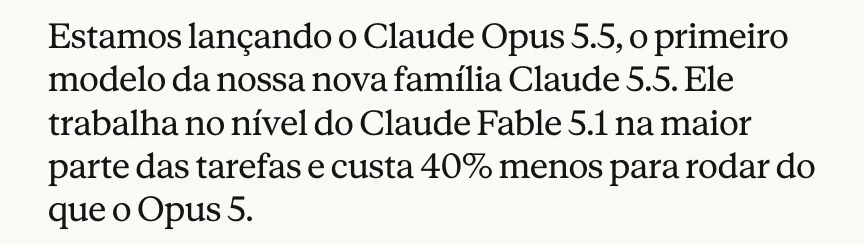
Olha o tamanho disso. O Fable 5.1 saiu faz três semanas como o modelo mais forte da casa, aquele que a própria Anthropic dizia pra usar quando o Opus 5 não desse conta. Agora o Opus, que é o modelo do dia a dia, chega nesse nível na maior parte do trabalho gastando menos.
Na API o nome é claude-opus-5-5. Está disponível em todas as plataformas deles, incluindo AWS, Google Cloud e Microsoft Azure.
Onde entram os 40%
Aqui vale ler com calma, porque o 40% não é só o preço da tabela.
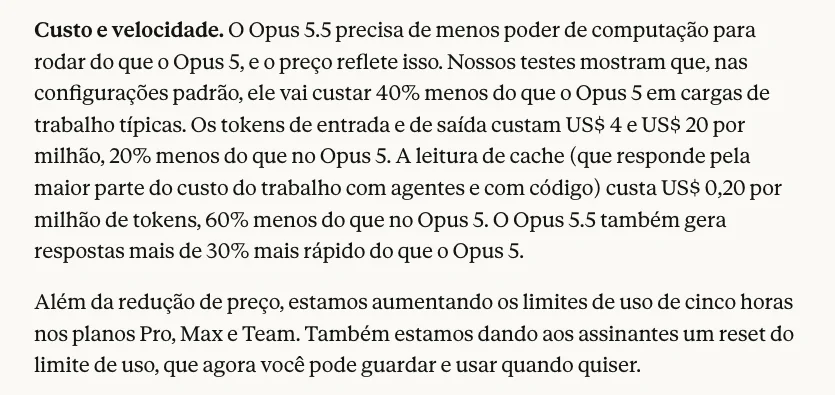
A Anthropic escreve que o Opus 5.5 precisa de menos poder de computação pra rodar do que o Opus 5, e que o preço reflete isso. A tabela, em dólar, por milhão de tokens:
- Entrada: US$ 4 (o Opus 5 era US$ 5)
- Saída: US$ 20 (era US$ 25)
- Releitura do contexto guardado: US$ 0,20 (era US$ 0,50)
Por token, ficou 20% mais barato. A releitura do contexto guardado, que é quando o modelo lê de novo o que já tinha processado, caiu 60%, e segundo eles é a maior parte do custo de quem trabalha com agente e com código.
O resto da conta vem de outro lugar: o Opus 5.5 usa menos token pra fazer a mesma tarefa. Somando as duas coisas, no esforço padrão, a Anthropic diz que uma tarefa típica sai 40% mais barata do que no Opus 5.
E ficou mais rápido também. Ele gera resposta mais de 30% mais rápido que o Opus 5. Se você precisa de velocidade de verdade, tem o fast mode no Claude Code e na Plataforma Claude, até 2,5 vezes mais rápido, por US$ 8 de entrada e US$ 40 de saída.
O exemplo que eles deram mostra bem a diferença. Um testador usou o Opus 5.5 pra auditar e corrigir um sistema de 200 mil linhas de código em menos de três horas. O Opus 5 levou mais de 20 horas no mesmo trabalho e gastou 2,5 vezes mais tokens.
A Optiver, uma empresa de trading, contou na página que o Opus 5.5 entregou a mesma qualidade do Opus 5 em mais ou menos metade dos passos, do tempo e dos tokens, e que isso cortou de 40% a 50% do custo daquele trabalho.
E tem a comparação com a OpenAI, que eles fizeram questão de colocar: no esforço padrão, o Opus 5.5 passa o GPT-6 Astra num teste de programação (FrontierCode) custando cerca de 20% do que o Astra custa por tarefa. No Terminal-Bench 4.0 ele empata com o Astra por uns 40% do custo.
Limite maior e o reset que eu cobrei
Quem paga assinatura vai sentir isso antes de qualquer benchmark. Além da queda de preço, eles aumentaram o limite de uso de cinco horas nos planos Pro, Max e Team. E todo mundo que tem assinatura ganhou um reset do limite, que você guarda e usa quando escolher.
Esse detalhe do "quando escolher" é o que faz diferença. Eles não zeraram o limite de todo mundo na mesma hora. Deixaram guardado pra você apertar no dia em que precisar. Na minha conta ele apareceu assim, com prazo até 22 de outubro:
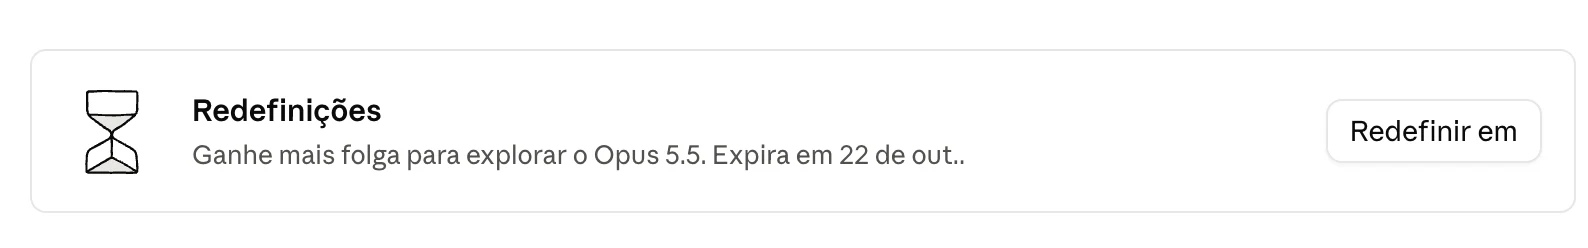
Então não gasta num dia qualquer. Guarda pra semana de lançamento, pra aquela sessão longa em que você vai refazer o site inteiro, pro dia em que o limite estoura no meio da entrega. No meu caso o plano de 20x já resetava hoje à noite, então o meu reset ficou guardado pra quando apertar.
A escrita: o ponto que mais importa pra quem faz copy
Pra mim essa é a melhor parte do lançamento. A Anthropic escreveu:
Ou seja, isso era uma das reclamações que eles mais ouviam sobre o Opus 5. E eles descrevem três mudanças. Ele coloca a informação mais importante primeiro, usa menos jargão e menos expressão esquisita, e segue as regras de escrita que você passa pra ele.
Logo abaixo tem uma comparação lado a lado que mostra isso melhor do que qualquer explicação. A mesma pergunta, "me explica o problema", pros dois modelos. O Opus 5 responde com um textão cheio de código. O Opus 5.5 abre com a conclusão na primeira linha, diz quanto dinheiro o erro custou e só depois mostra o que mudou.
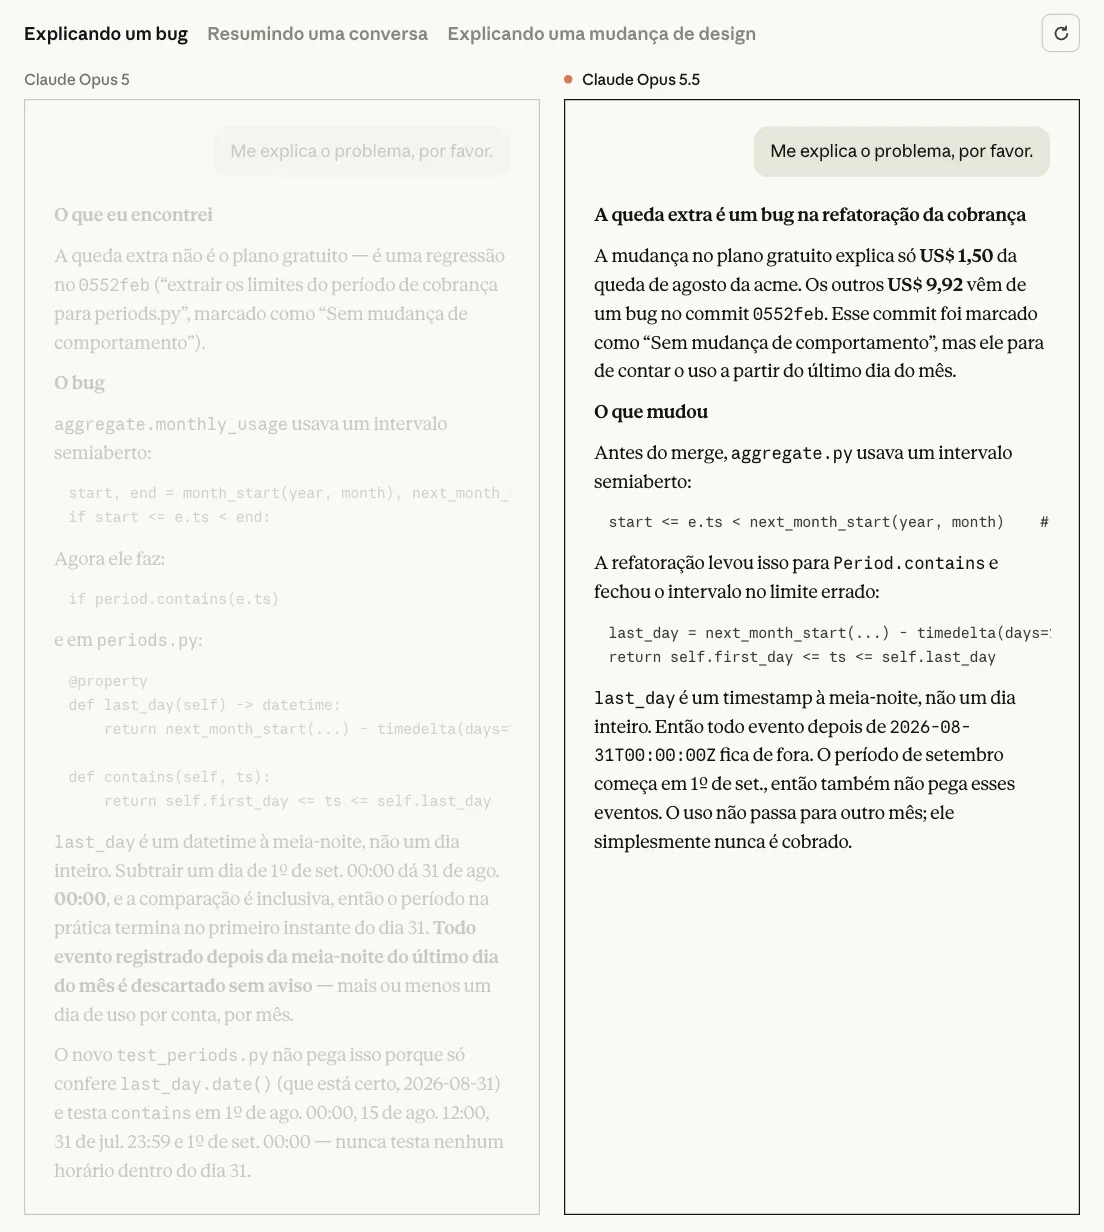
Essa última mudança, a de seguir as regras de escrita, é a que mais muda o jogo pra quem escreve copy. Se você tem um documento com a voz da sua marca, a lista de palavras que não pode usar, o tamanho de frase, o jeito de fechar um e-mail, o Opus 5.5 foi feito pra obedecer isso.
Três empresas falaram disso na página. A Ramp disse que texto longo e difícil de acompanhar era a maior frustração deles com os modelos de ponta, e que o Opus 5.5 resolve isso, escrevendo como um bom colega e seguindo as regras de escrita da empresa. A Box mediu respostas 40% menos prolixas, usando um terço dos tokens do Opus 5, sem perder precisão. E a Chicago Trading Company contou que a documentação que o modelo escreve pra eles quase não precisa de edição.
E tem um lado que eu falei no post e quero reforçar aqui. Mensagem que você entende batendo o olho, com o principal logo na primeira linha, é ótima pra quem tem TDAH. A própria Anthropic conta que os testadores sentiram isso nas sessões longas de trabalho. Quem passa três horas seguidas no Claude Code sabe o cansaço que é ler parágrafo gigante pra achar a única frase que importava.
Segurança, e por que ele é comparado ao Mythos
A Anthropic roda uma auditoria automática de comportamento com quase 2 mil cenários, que eles chamam de o teste de alinhamento mais completo que fazem. O Opus 5.5 foi o modelo com o melhor resultado que eles já testaram.
Na prática, pra quem deixa o Claude trabalhando sozinho no projeto, isso quer dizer que ele fica mais dentro do que você autorizou. Eles escrevem que o Opus 5.5 tem bem menos chance de tomar uma ação difícil de desfazer ou de sair dos limites que você deu.
A comparação com o Mythos 5.1 aparece numa frase específica: o Opus 5.5 é comparável ao Mythos 5.1 em biologia e cibersegurança. Por isso ele sai com travas parecidas com as do Fable 5.1 nessas duas áreas. Quem pesquisa biologia ou trabalha com segurança pode pedir acesso ampliado pelos programas de verificação da Anthropic. Pro seu dia a dia de copy, página e automação, isso não muda nada.
Os números lado a lado
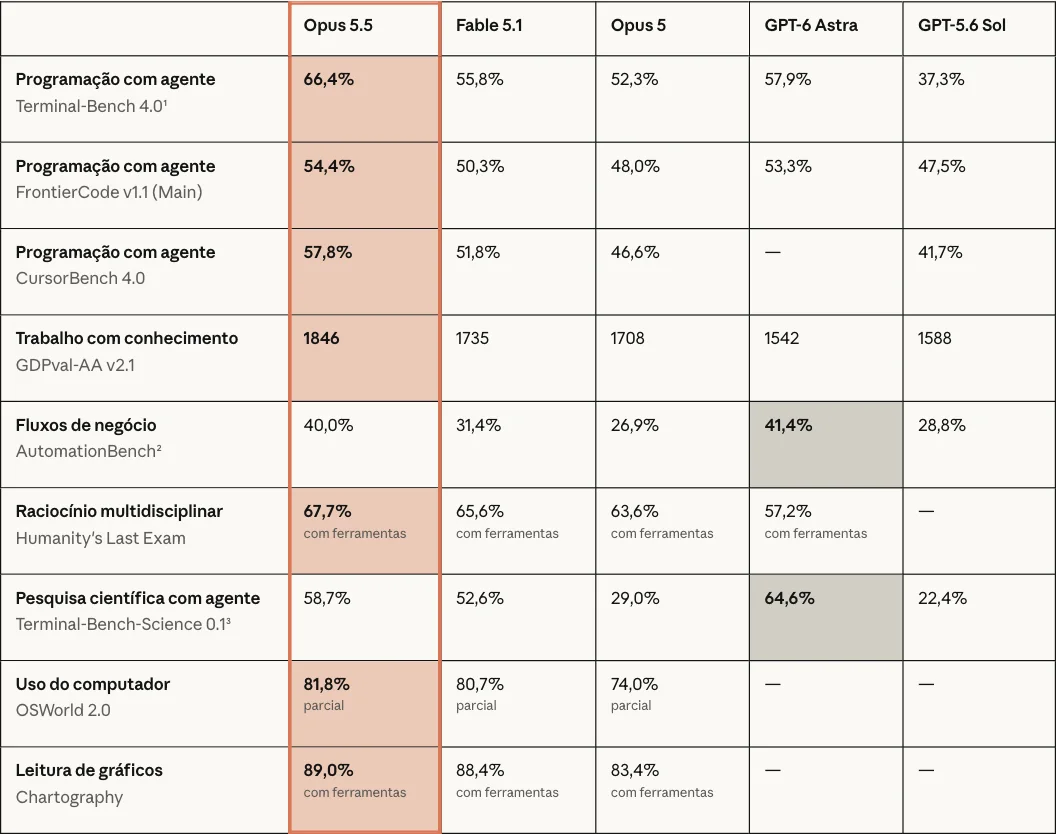
A Anthropic publicou a tabela contra Fable 5.1, Opus 5, GPT-6 Astra e GPT-5.6 Sol:
Os que mais importam pra quem opera IA:
- Programação com agente (Terminal-Bench 4.0): Opus 5.5 66,4% · Fable 5.1 55,8% · Opus 5 52,3% · GPT-6 Astra 57,9%
- Programação (FrontierCode v1.1): Opus 5.5 54,4% · Fable 5.1 50,3% · Opus 5 48,0% · GPT-6 Astra 53,3%
- Trabalho de escritório e conhecimento (GDPval-AA v2.1): Opus 5.5 1846 · Fable 5.1 1735 · Opus 5 1708 · GPT-6 Astra 1542
- Uso do computador (OSWorld 2.0): Opus 5.5 81,8% · Fable 5.1 80,7% · Opus 5 74,0%
- Pesquisa científica com agente (Terminal-Bench-Science 0.1): Opus 5.5 58,7% · Fable 5.1 52,6% · GPT-6 Astra 64,6%
Repara que ele passa o Fable 5.1 em quase tudo nessa tabela, e mesmo assim a própria Anthropic avisa que, no uso deles, a diferença entre os dois é menor do que os números sugerem. E em pesquisa científica e em automação de fluxo de negócio o Astra ainda fica na frente. Gostei de eles terem escrito isso, porque ajuda a não sair trocando tudo achando que o Opus virou outro modelo.
O que vem depois
Se o padrão se repetir, a família inteira fica mais barata e escreve melhor. Pra quem roda automação no Haiku ou no Sonnet por causa do preço, vale ficar de olho.
Onde eu seguraria a empolgação
Todo número dessa página é da Anthropic e dos clientes que ela escolheu pra aparecer ali. O 40% vale no esforço padrão, em trabalho típico. Se você usa sempre no esforço máximo, ou o seu uso é muito diferente do deles, a conta muda.
O "nível do Fable 5.1" também vem com um "na maior parte do trabalho" do lado. Tarefa de raciocínio muito pesado ainda pode pedir o Fable.
E a escrita melhorou, mas ela segue a regra que você dá. Se você não passa regra nenhuma, ele escreve do jeito padrão dele, que é melhor que o do Opus 5 e ainda assim genérico. O que faz a copy sair com a cara da sua marca continua sendo o contexto que você entrega pra IA.
Como testar hoje
Abre o Claude ou o Claude Code e confere se o Opus 5.5 já aparece no seletor de modelo.
Depois pega uma tarefa que você fez com o Opus 5 nessa semana, uma copy, uma página, um relatório, e refaz no Opus 5.5 com o mesmo contexto. Compara o texto e compara quanto do seu limite foi embora. Esse é o teste que importa, porque é no seu trabalho.
Na hora de pedir, cola junto o guia de voz da sua marca ou a sua lista de palavras proibidas, e pede pra ele colocar o mais importante na primeira linha. É aí que dá pra ver se ele segue mesmo as suas regras.
E o reset, guarda. Ele vale até 22 de outubro, e o dia em que você vai precisar dele ainda não chegou.
A página completa da Anthropic está aqui: anthropic.com/claude-opus-5-5.