GPT-6 Sol e Luna, pela metade do preço.
O Sol é o do trabalho pesado do dia a dia, o Luna é o rápido e barato. Os dois custam metade da versão 5.6, escrevem mais claro e já estão no ChatGPT Work e no Codex. O Luna chega até pra conta grátis, no app de desktop.
Hoje eu escrevi aqui sobre o Opus 5.5. E a OpenAI não esperou nem o dia acabar. Segundo o TechCrunch, o GPT-6 Sol e o GPT-6 Luna saíram 90 minutos depois do lançamento da Anthropic.
E o recado deles é bem direto: os dois modelos novos custam metade do que custava a versão anterior.
Então vamos por partes de novo. Tudo que está aqui embaixo saiu da página oficial da OpenAI, traduzido e em palavras simples.
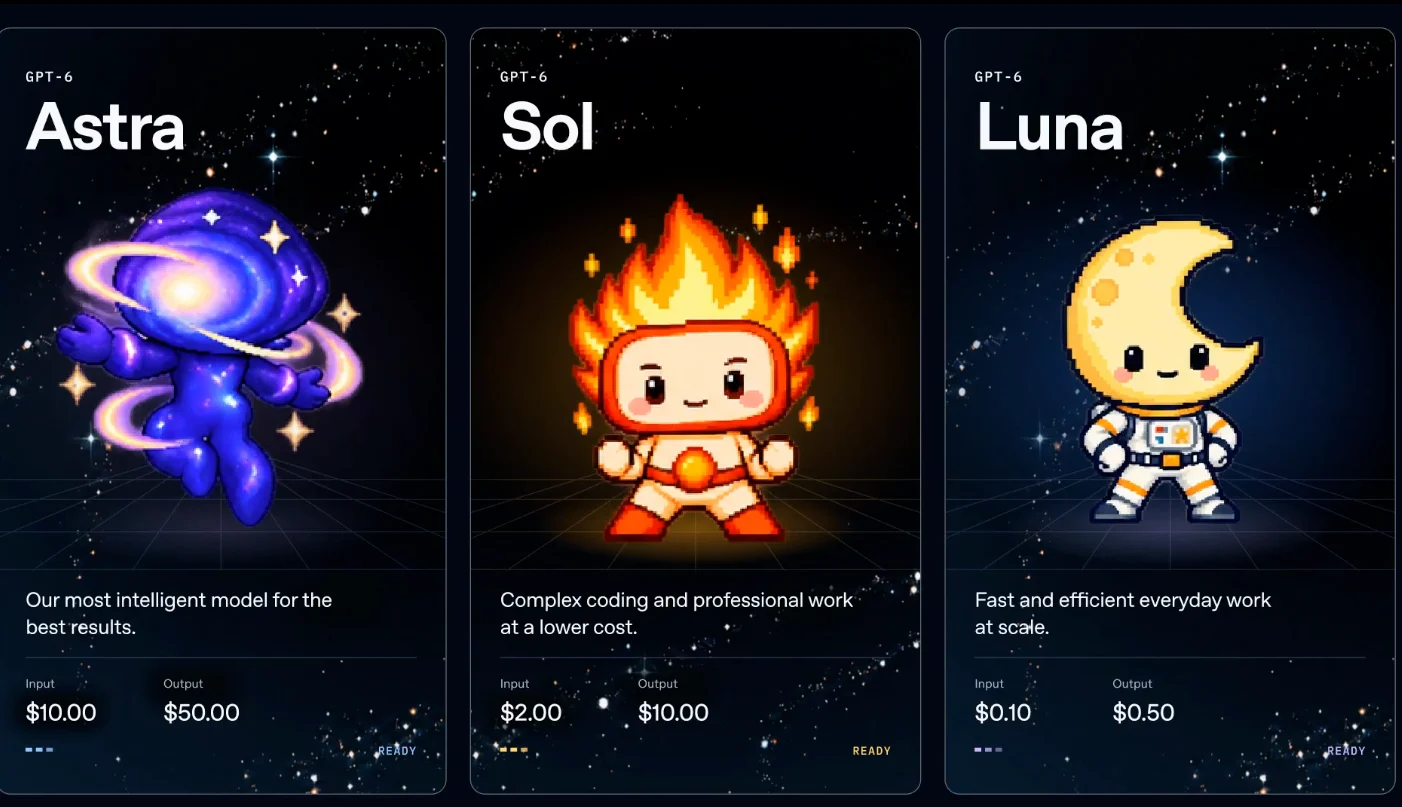
A família GPT-6 agora tem três modelos
Pensa assim. O Astra, que saiu no começo do mês, é o mais inteligente e o mais caro. O Sol é o do trabalho pesado do dia a dia, programação e trabalho profissional, custando bem menos. E o Luna é o rápido e barato, feito pra tarefa simples em grande volume.
- GPT-6 Astra: US$ 10 de entrada e US$ 50 de saída, por milhão de tokens
- GPT-6 Sol: US$ 2 de entrada e US$ 10 de saída
- GPT-6 Luna: US$ 0,10 de entrada e US$ 0,50 de saída
A abertura da página explica a lógica: o Astra continua sendo o melhor deles pra tudo, mas nem todo trabalho precisa dele. Eles treinaram o Sol e o Luna com métodos parecidos com os do Astra e levaram o que o Astra tem de melhor pra modelos mais rápidos e mais baratos.
O preço caiu pela metade
Esse é o centro do lançamento. A OpenAI diz que melhorou o cache e a forma de rodar os modelos, conseguiu servir mais barato e repassou a economia pra quem usa.
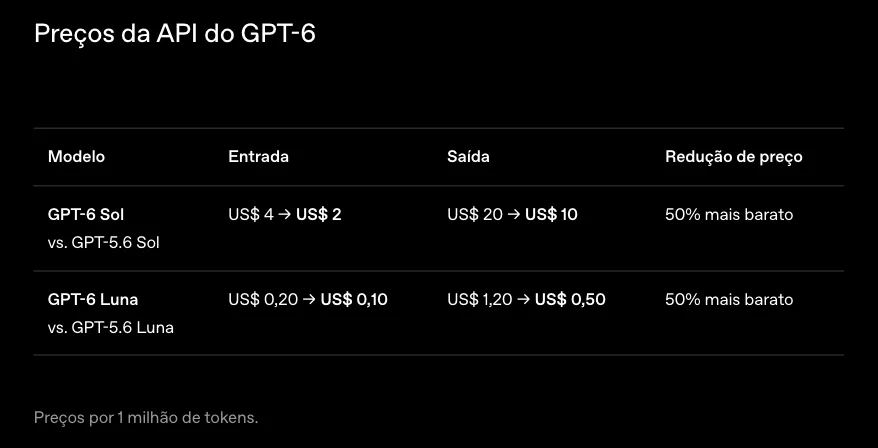
O Sol saiu de US$ 4 pra US$ 2 na entrada e de US$ 20 pra US$ 10 na saída. O Luna saiu de US$ 0,20 pra US$ 0,10 na entrada e de US$ 1,20 pra US$ 0,50 na saída. A comparação deles é com o preço promocional da versão 5.6.
Pra ter uma régua: o Opus 5.5 que saiu hoje custa US$ 4 de entrada e US$ 20 de saída, segundo a Anthropic. O Sol novo custa metade disso por token. Só que, como a gente viu no post do Opus, preço por token não conta a história inteira. Quanto token cada modelo gasta pra fazer a mesma tarefa muda a conta, e cada empresa mede isso no próprio teste.
Tem uma parte menos chamativa que pesa bastante pra quem roda agente: o cache ficou melhor. Quando o modelo reaproveita o contexto que já leu, a leitura desse contexto sai com 90% de desconto. E agora dá pra mudar o nível de esforço e ligar ou desligar ferramentas sem perder o que estava guardado. O GitHub contou na página que, nos últimos meses, essas melhorias cortaram em mais de 50% a parte do prompt que precisava ser processada do zero, e isso deixou o Copilot mais rápido.
Falta o resto desta edição
Inscrição única, uma vez só. Libera esta e todas as outras edições, e você recebe as próximas no e-mail assim que entrarem no ar.