Essa IA promete ser até 400x mais barata que o ChatGPT, respondendo em 150 milissegundos contra 3 segundos do ChatGPT ou do Claude.
A TypeSafe lançou o Jev, uma IA que não escreve: decide. O que ela é, quem fez, os números com fonte, o teste que eu rodei na Nomics e onde ela entra num lançamento.
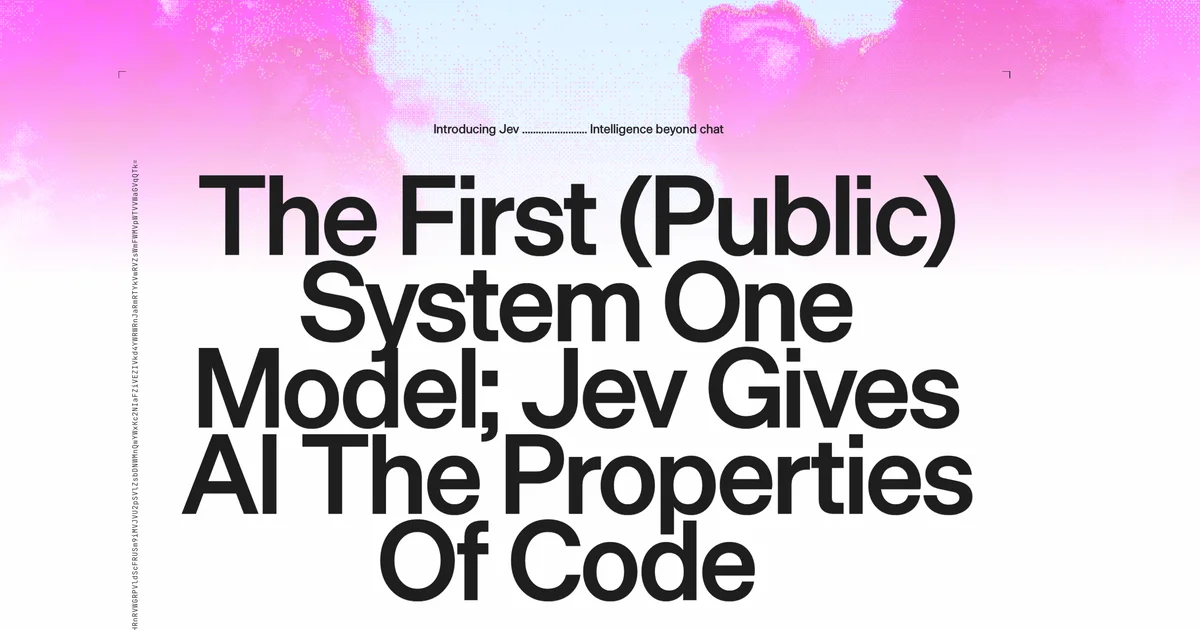
Olha esse print.
Do lado esquerdo, a TypeSafe. Do lado direito, um modelo da OpenAI. Os dois receberam a mesma mensagem de cliente e as mesmas 27 perguntas sobre ela.
A TypeSafe respondeu tudo em 0,114 segundo e custou US$ 0,000081.
O modelo da OpenAI levou 8,566 segundos e custou US$ 0,013880.
Mesma tarefa. Umas 75 vezes mais rápido e umas 170 vezes mais barato, nesse teste que a própria TypeSafe mostrou no lançamento.
A TypeSafe ocupa o lugar onde o ChatGPT e o Claude sempre foram caros, lentos e imprevisíveis: a decisão pequena que se repete milhares de vezes dentro de um sistema. Esse lead quer comprar? Essa mensagem é reclamação? Essa resposta de pesquisa fala de medo ou de dinheiro?
Quem trabalha com lançamento tem esse tipo de decisão aos montes. E até agora ou fazia na mão, ou fazia com regra fixa que não entende nada, ou pagava um modelo grande pra ler uma linha de cada vez.
O que é, sem enrolação
O nome do modelo é Jev. A TypeSafe chama essa categoria de "System One", o pensamento rápido.
Ele não escreve texto. Você manda um texto e faz perguntas fechadas. Ele devolve a resposta e o quanto tem certeza. Só três tipos de pergunta:
- Escolha (Choice). "Qual a intenção dessa mensagem: compra, dúvida, reclamação ou outro?" Volta a opção escolhida e a probabilidade de cada uma.
- Nota (Score). "Quão urgente é responder: sem pressa, no dia ou agora?" Volta uma nota na escala que você descreveu.
- Sim ou não (Noul). "A pessoa pede reembolso?" Volta a chance de ser sim.
Você pode mandar várias perguntas na mesma chamada. Todas rodam ao mesmo tempo. Foi assim que as 27 perguntas do print voltaram em um décimo de segundo.
A diferença pra quem constrói automação é enorme. Com o ChatGPT você pede um JSON, reza pra ele vir no formato certo, e ainda escreve código pra conferir. Com o Jev a resposta já vem no formato que o sistema usa. Sem texto no meio.
Quem fez e por quê
A TypeSafe foi criada pelo Diogo Almeida. No vídeo de lançamento ele se apresenta assim: na OpenAI, ajudou a criar o ChatGPT e o RLHF, o método de treino que está por trás da maioria dos modelos de ponta.
A pergunta que ele conta ter feito é boa: se os modelos já são sobre-humanos em conversa, por que isso não virou automação de verdade?
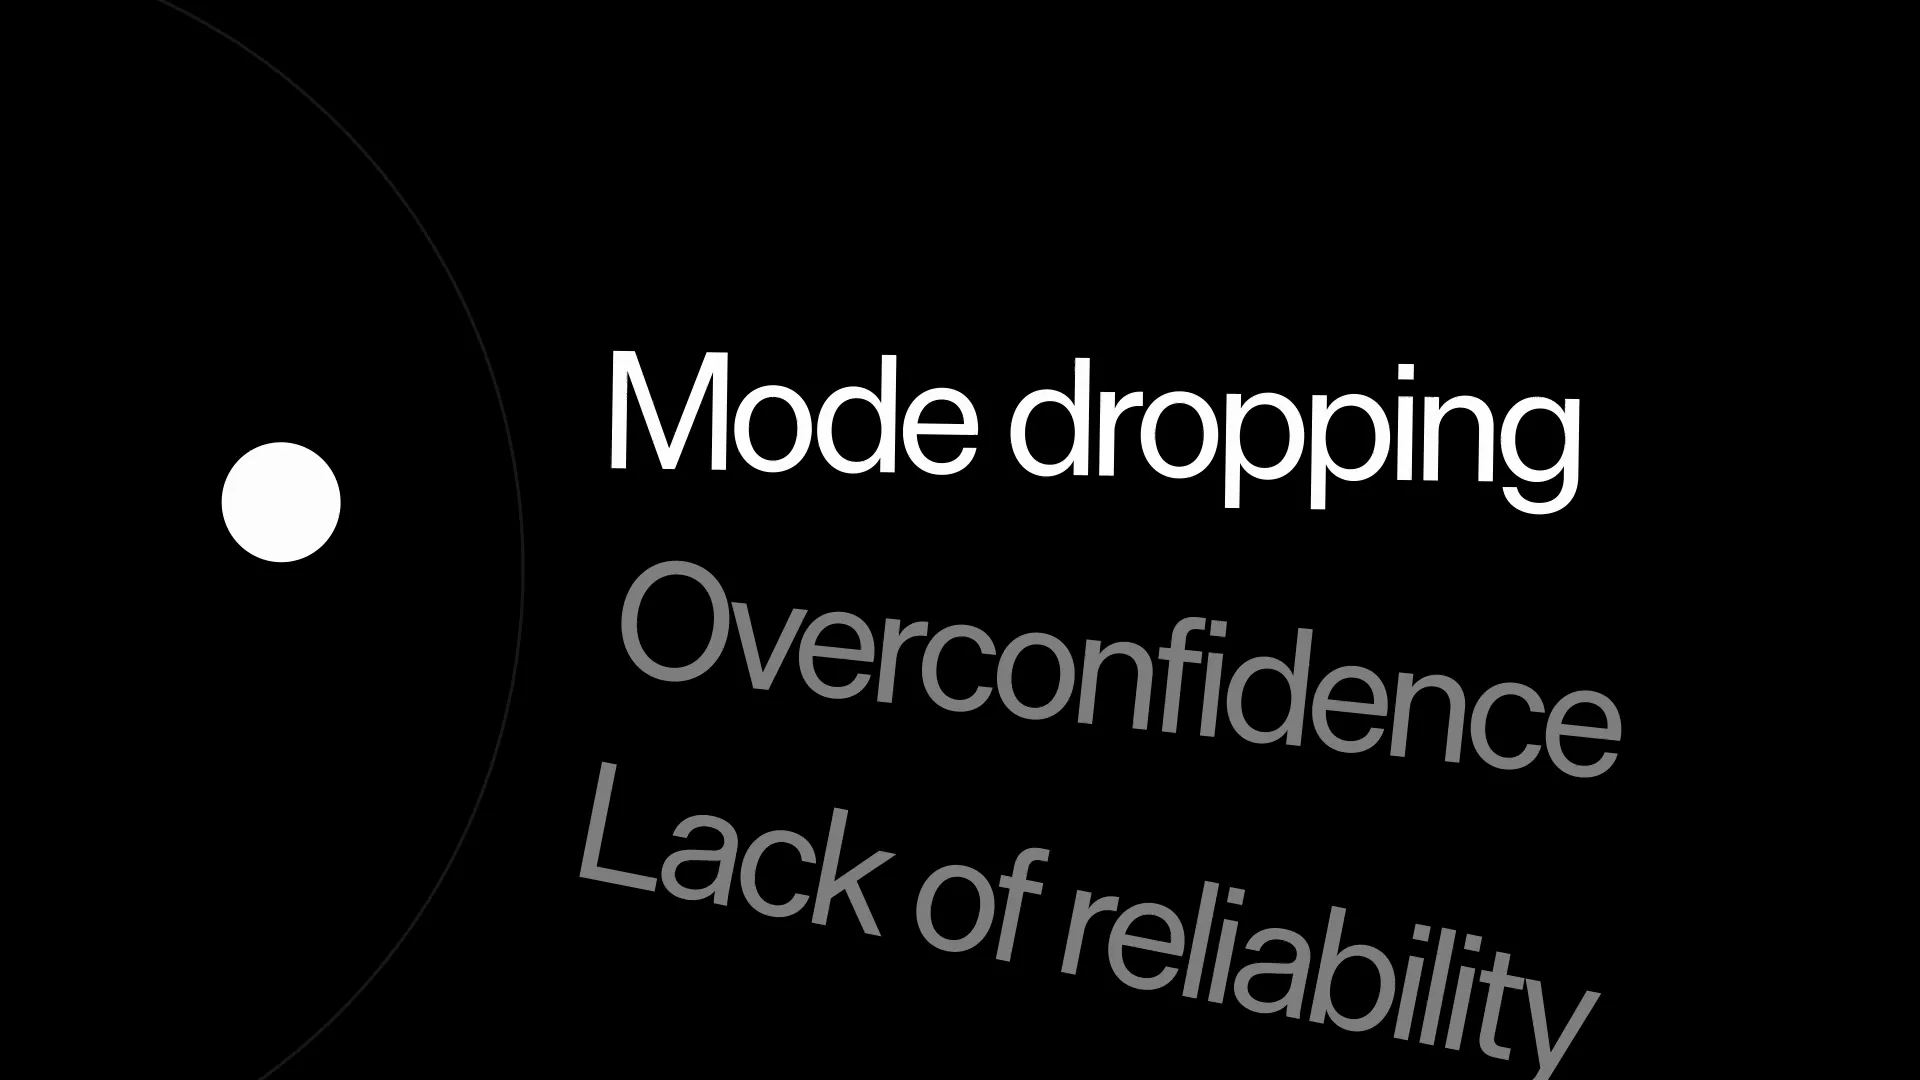
A resposta dele: o treino que deixa uma IA boa de papo otimiza a IA pra agradar gente. E isso traz três defeitos que quebram software. A IA fica confiante demais. Perde variedade nas respostas. E não é confiável o bastante pra rodar sem alguém olhando.
Então eles passaram dois anos construindo outra coisa: arquitetura nova, jeito novo de gerar a resposta (em paralelo, em vez de palavra por palavra) e um treino novo que eles chamam de RLCD, aprendizado por reforço pra decisões calibradas. Calibrada quer dizer que, quando ela diz 80% de certeza, ela acerta mais ou menos 80% das vezes.
A empresa saiu do modo sigiloso com US$ 40 milhões de investimento.
Os números, e de onde cada um vem
Todos os números desta seção são da própria TypeSafe. Eu não medi velocidade nem comparei com outros modelos. O teste que eu fiz está na próxima seção.
- 100 vezes mais barata e 100 vezes mais rápida. É a frase do Diogo no vídeo. No post do lançamento ele abre a faixa: de 20 a 200 vezes mais rápida e de 40 a 400 vezes mais barata.
- 150 milissegundos. Está na documentação oficial. No blog, a faixa é de 70 a 500 milissegundos, contra 3 a 329 segundos dos modelos de conversa.
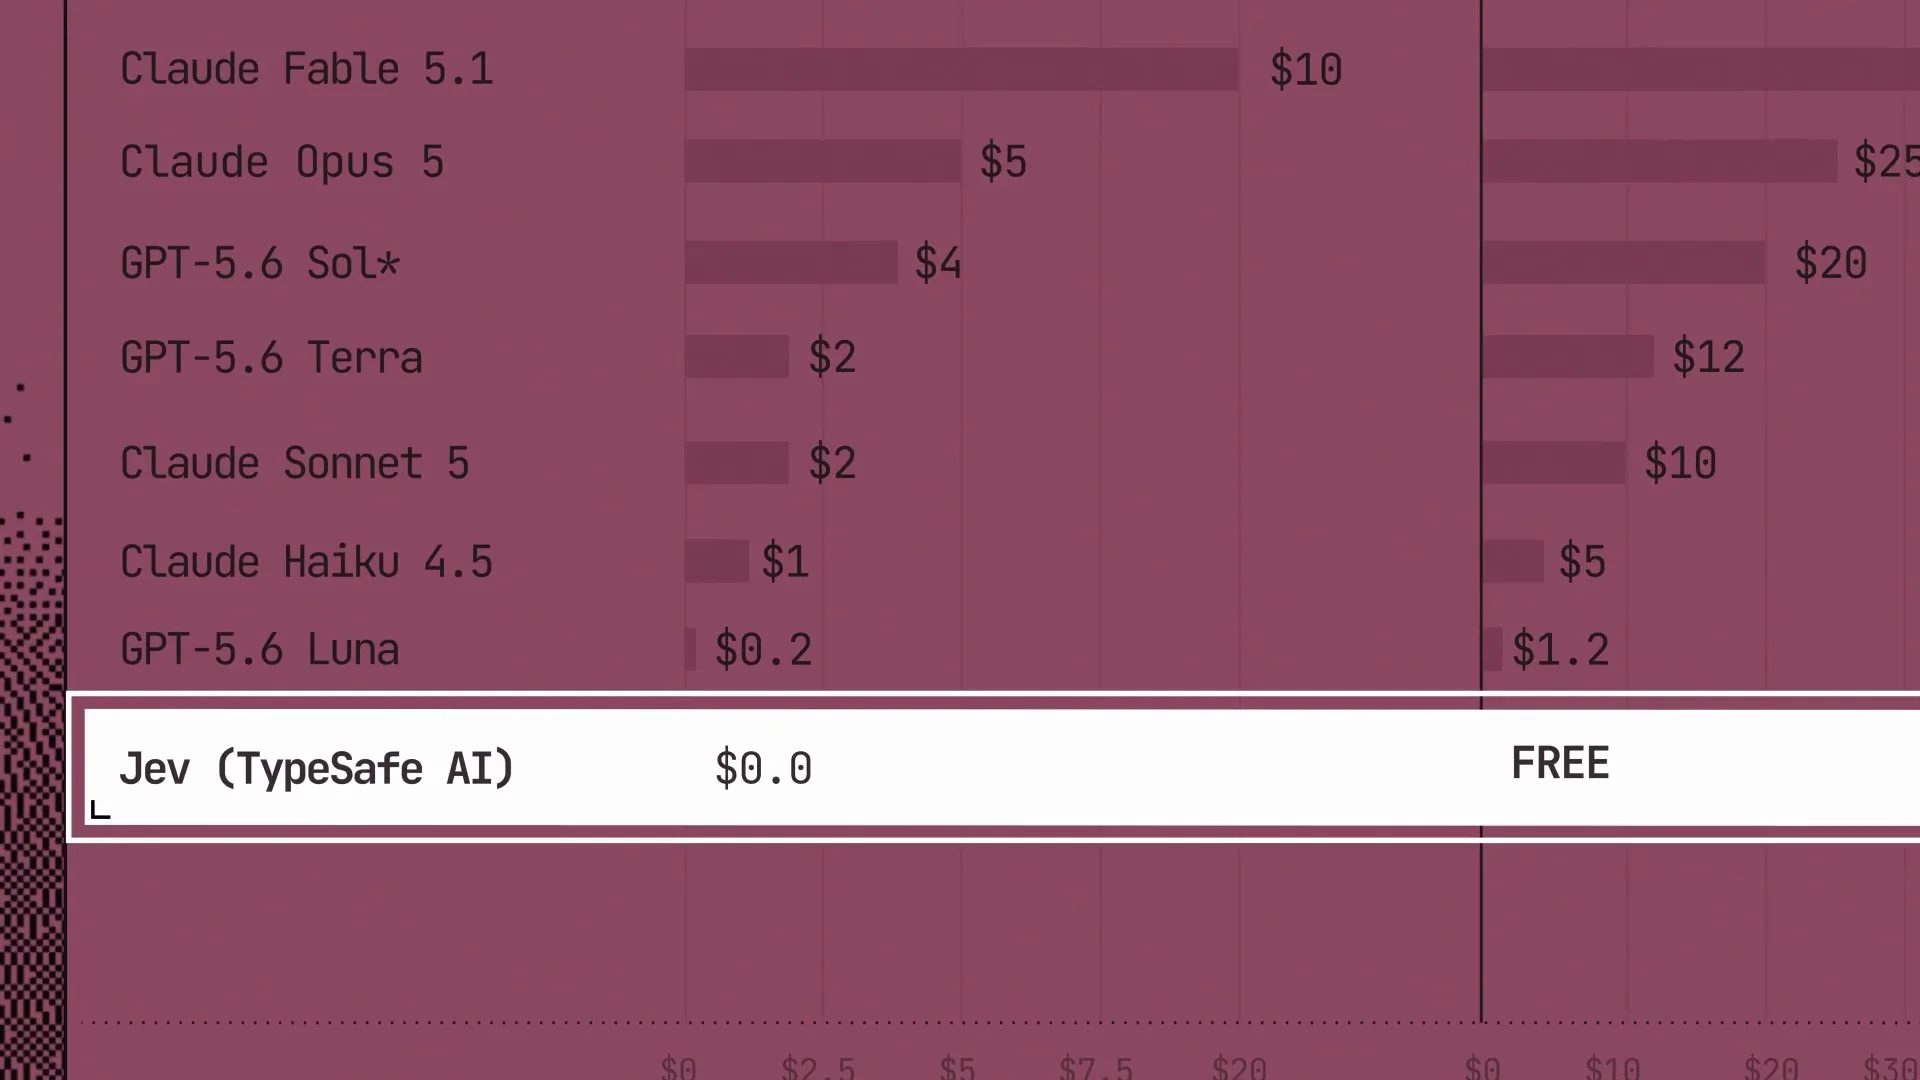
- US$ 0,042 por milhão de tokens enviados. E a resposta é grátis. Os modelos de conversa cobram a resposta, e cobram caro.
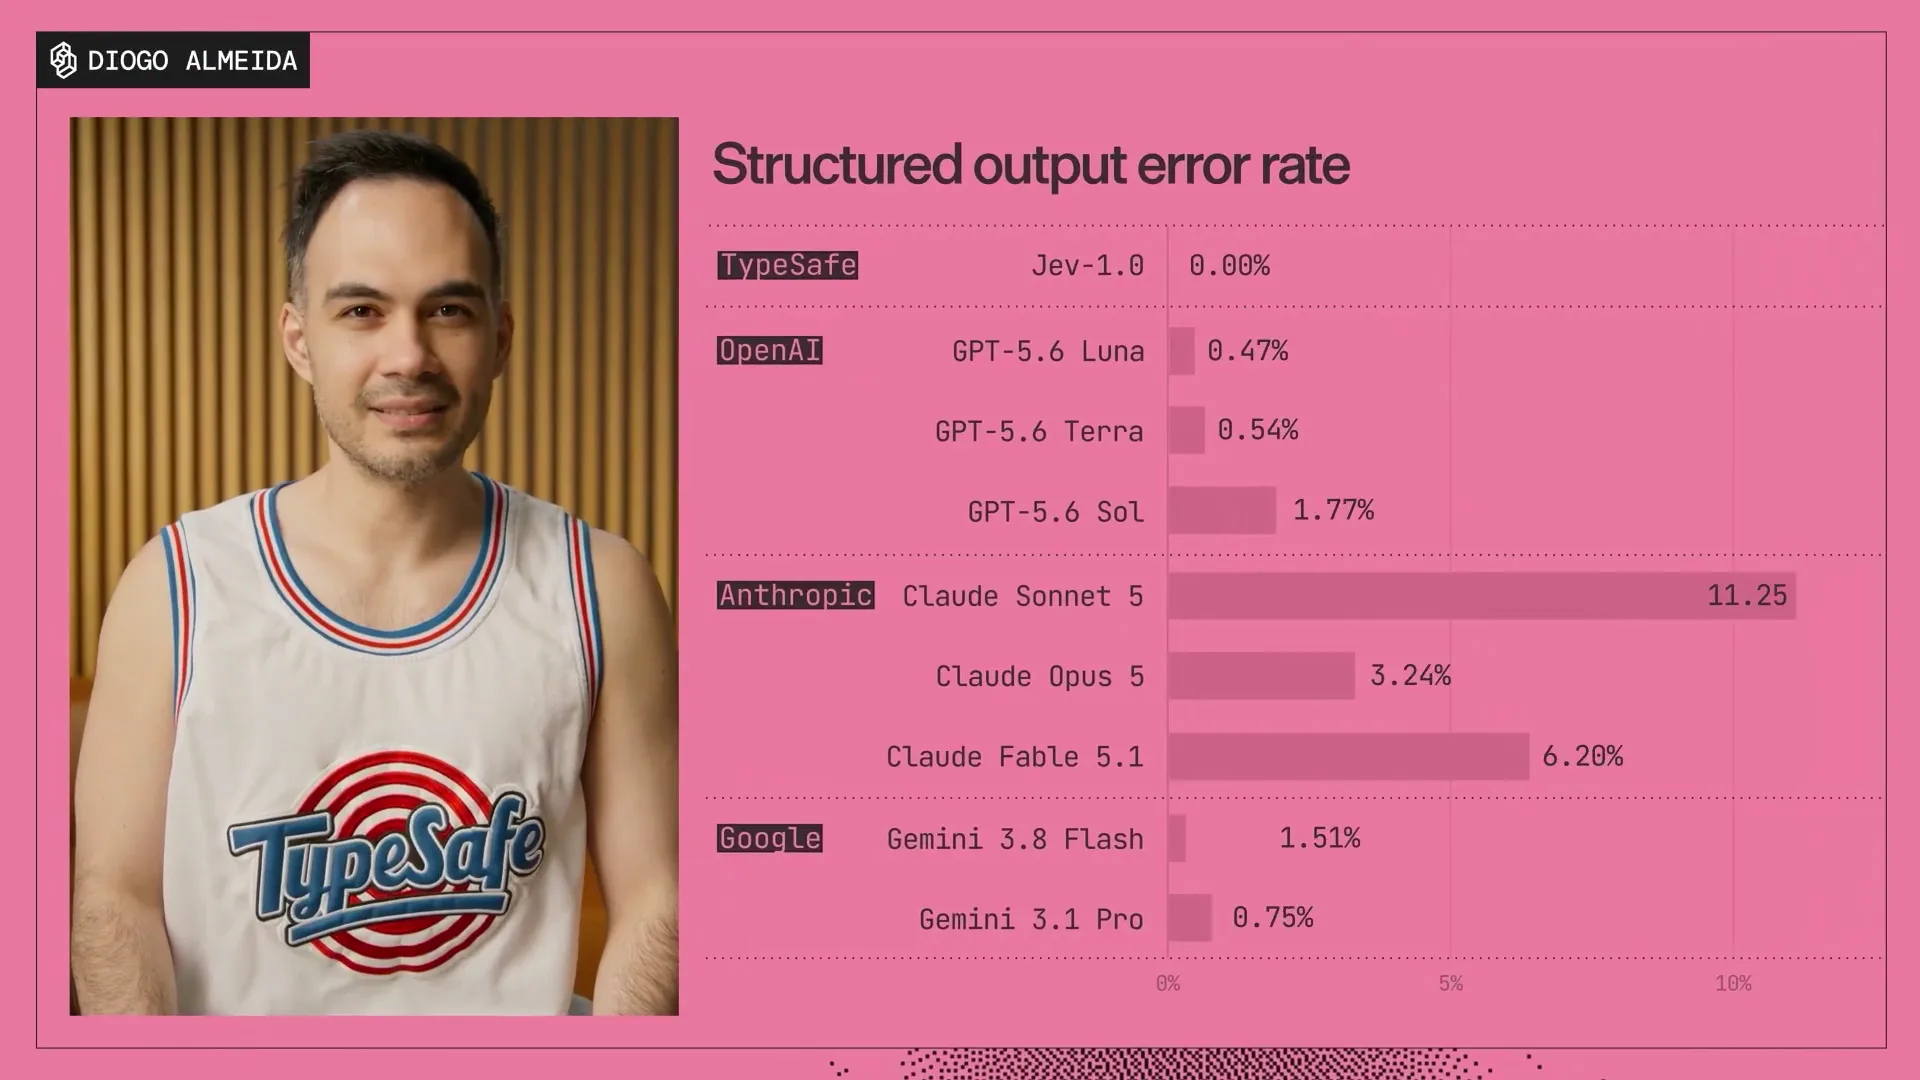
O gráfico que eu mais gostei é o de erro de formato. Quantas vezes o modelo devolve a resposta num formato que quebra o sistema. Segundo a TypeSafe: Jev com 0,00%. Claude Sonnet 5 com 11,25%. Claude Fable 5.1 com 6,20%. GPT-5.6 Terra com 0,54%.
E tem um gráfico que conta a verdade inteira, se você olhar com calma. Inteligência de um lado, custo por tarefa do outro. O Jev fica sozinho no canto do custo baixíssimo. Mas repara: na escala de inteligência ele fica perto dos 70%. Sol e Opus 5 ficam acima.
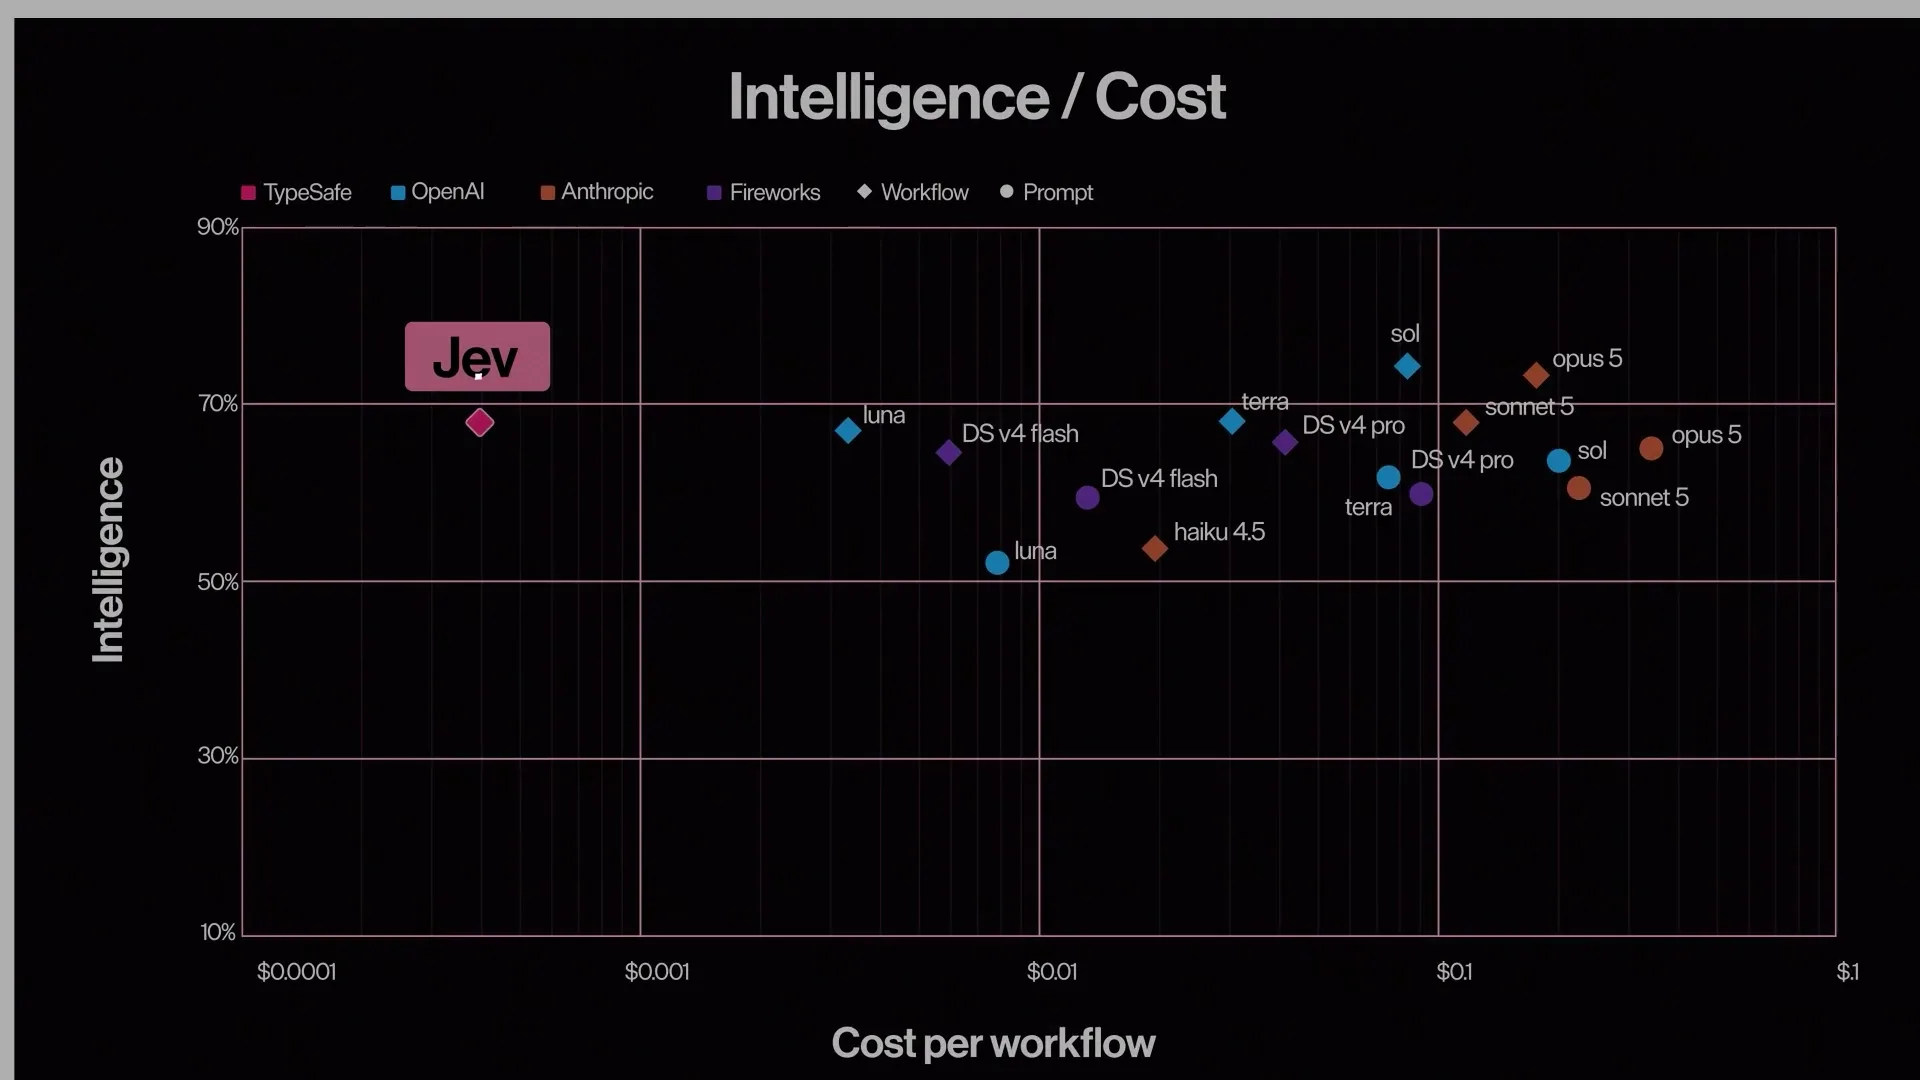
Ou seja, o Jev entrega inteligência suficiente pra decisão pequena por uma fração do preço, e fica atrás dos modelos grandes na decisão difícil. Pra pensar de verdade, o Claude e o ChatGPT continuam na frente.
O teste que eu fiz aqui na Nomics
Na hora que eu vi, fui testar com dado de verdade.
Pegamos as pesquisas de captação de cinco lançamentos de um projeto nosso. 4.735 respostas abertas, aquelas onde a pessoa escreve o sonho dela e o que impede de chegar lá. Sem nome, sem e-mail, sem telefone. Só o texto.
Pra cada resposta, sete perguntas. Qual o sonho principal. Qual o bloqueio. Já vende? Fala de medo? Fala de falta de dinheiro?
Resultado: 4,8 milhões de tokens, uns 20 centavos de dólar, poucos minutos, zero erro.
E ela entende português de lead de verdade. Resposta com erro de digitação, resposta de duas palavras, resposta que mistura dois assuntos. Milhares de jeitos diferentes de responder a mesma pergunta viraram colunas que dá pra filtrar numa planilha.
Agora a parte honesta, que ninguém vai te contar num vídeo de lançamento: a TypeSafe não tira conclusão. Ela classificou cada resposta. Cruzar com as vendas, contar, comparar e separar padrão de acaso foi trabalho meu com o Claude. A TypeSafe é a peça que transforma texto bagunçado em dado. A análise continua sendo de quem desenha a pergunta.
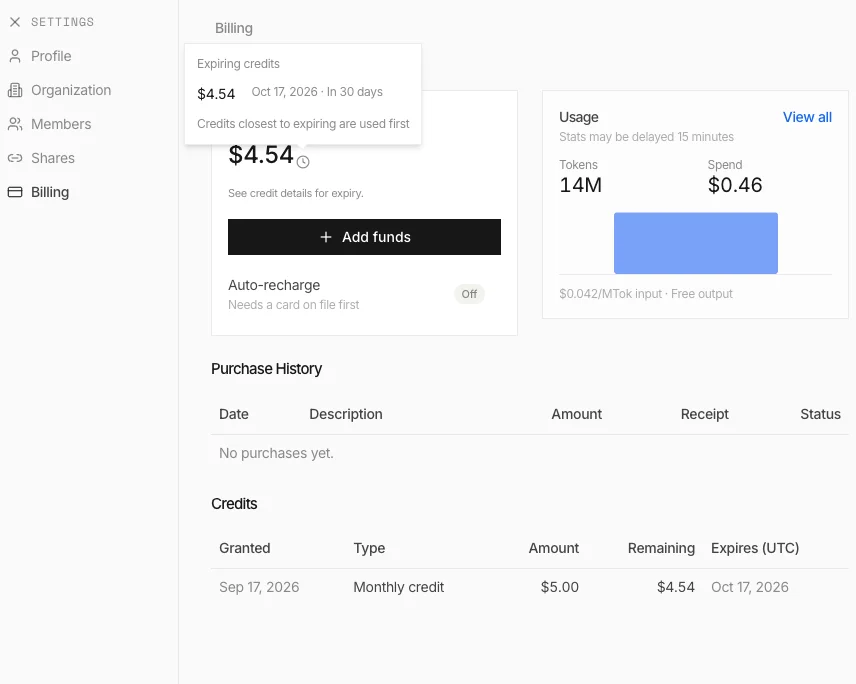
E o dia inteiro de teste, somando tudo que eu rodei? 14 milhões de tokens. 46 centavos de dólar. Saiu do crédito de 5 dólares que veio na conta.
Não sou só eu testando
Dois dias depois do lançamento, já tem gente mostrando uso de verdade. Três que eu separei:
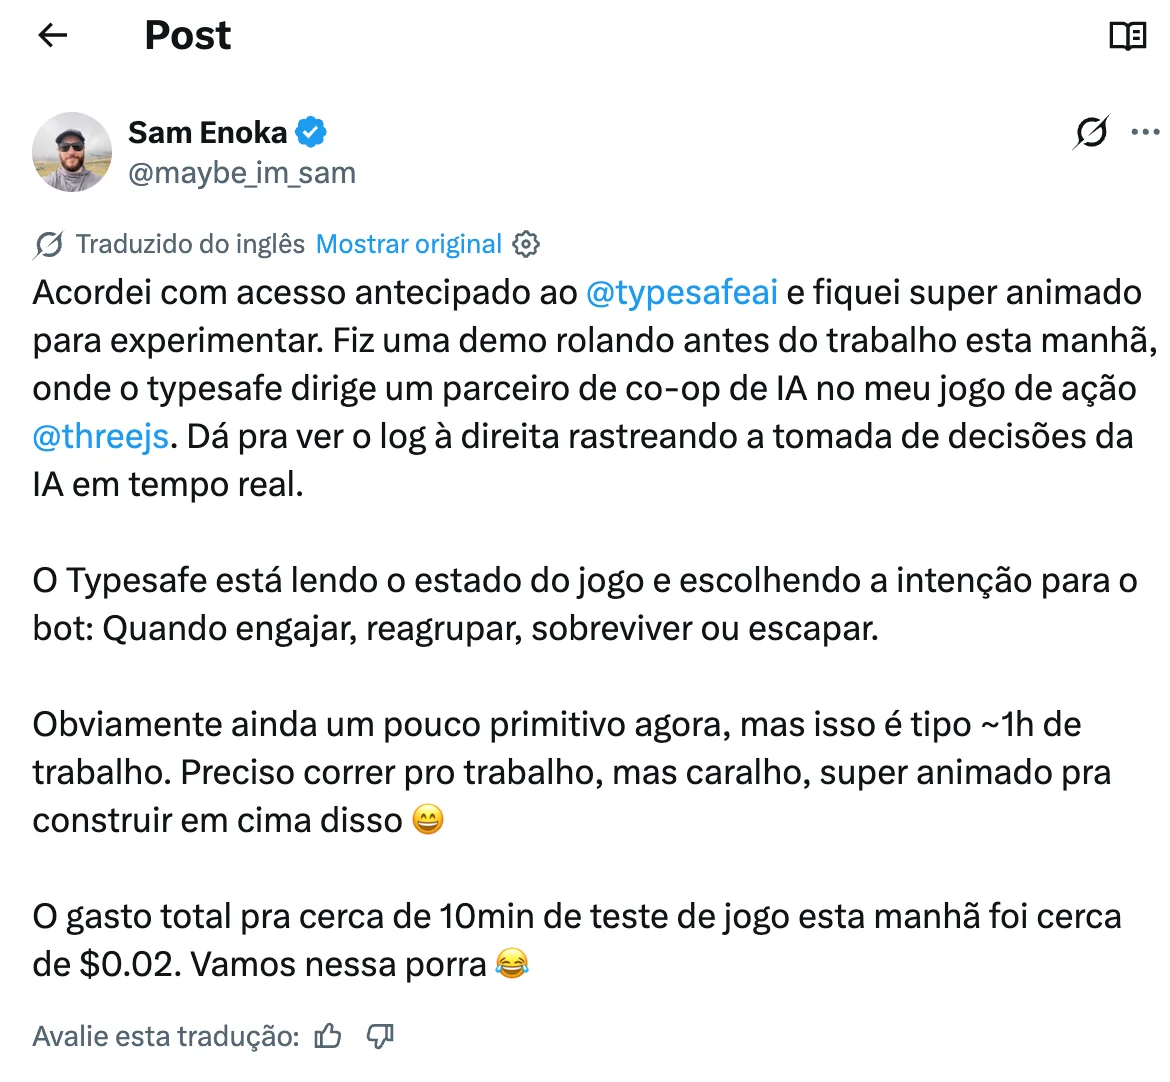
O Sam Enoka colocou a TypeSafe pra jogar. Ela lê o estado de um jogo de ação e decide o que o parceiro controlado por IA faz: engajar, reagrupar, sobreviver ou fugir. Segundo ele, foi cerca de uma hora de trabalho, e dez minutos jogando custaram mais ou menos 2 centavos de dólar.
O Riley Brown classificou a caixa de e-mail. 500 e-mails separados em newsletter, marketing, notificação, alerta de serviço, oferta fria, com urgência e se precisa de resposta. Segundo ele, em segundos, por 3,5 centavos de dólar.
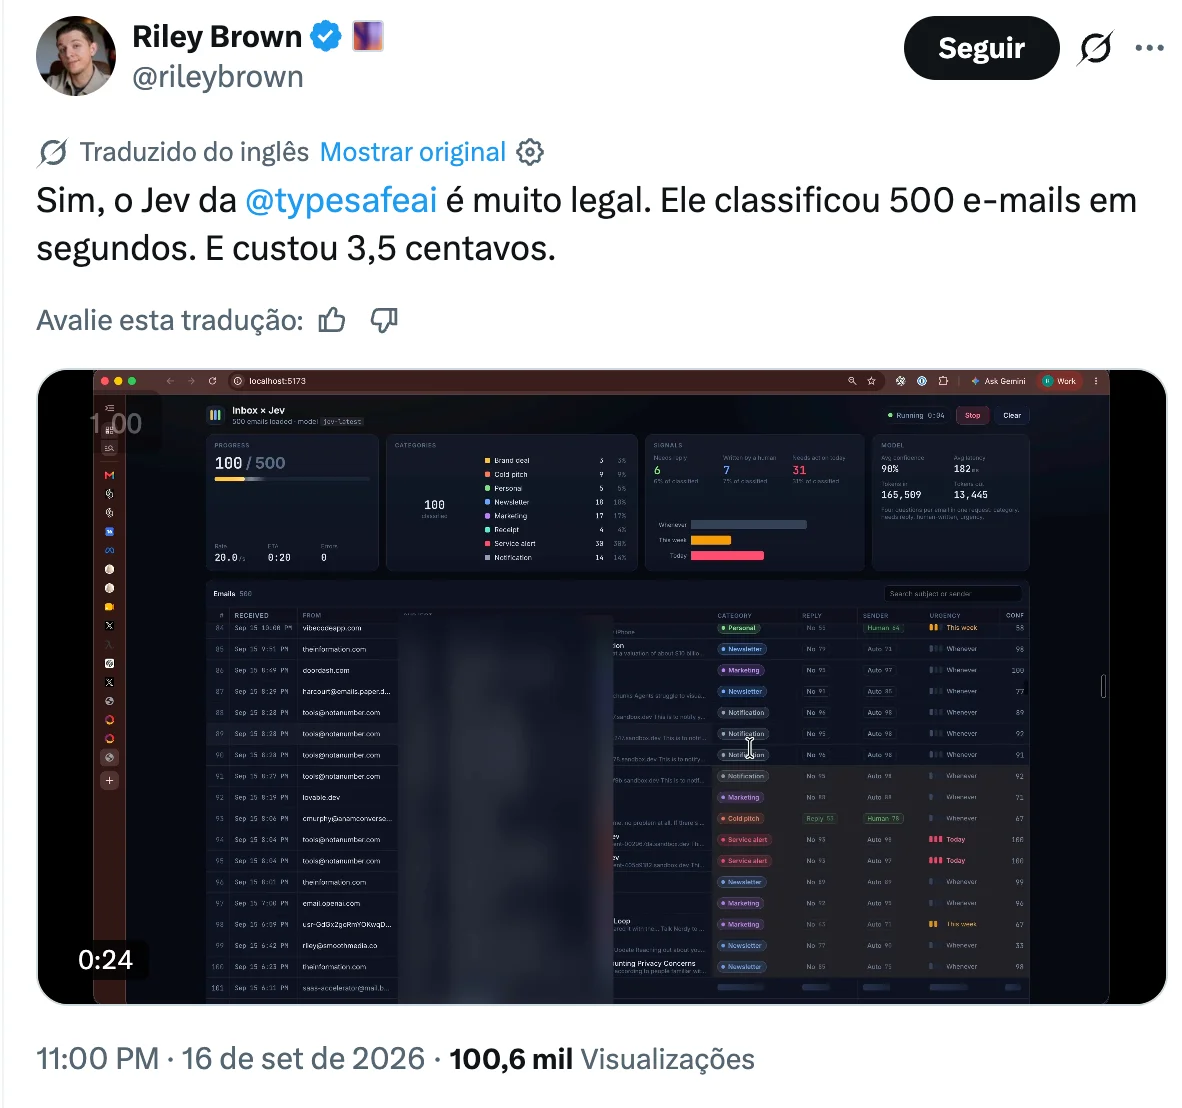
É o mesmo uso da triagem de WhatsApp de um lançamento. Troca e-mail por mensagem de lead e a planilha é igual.
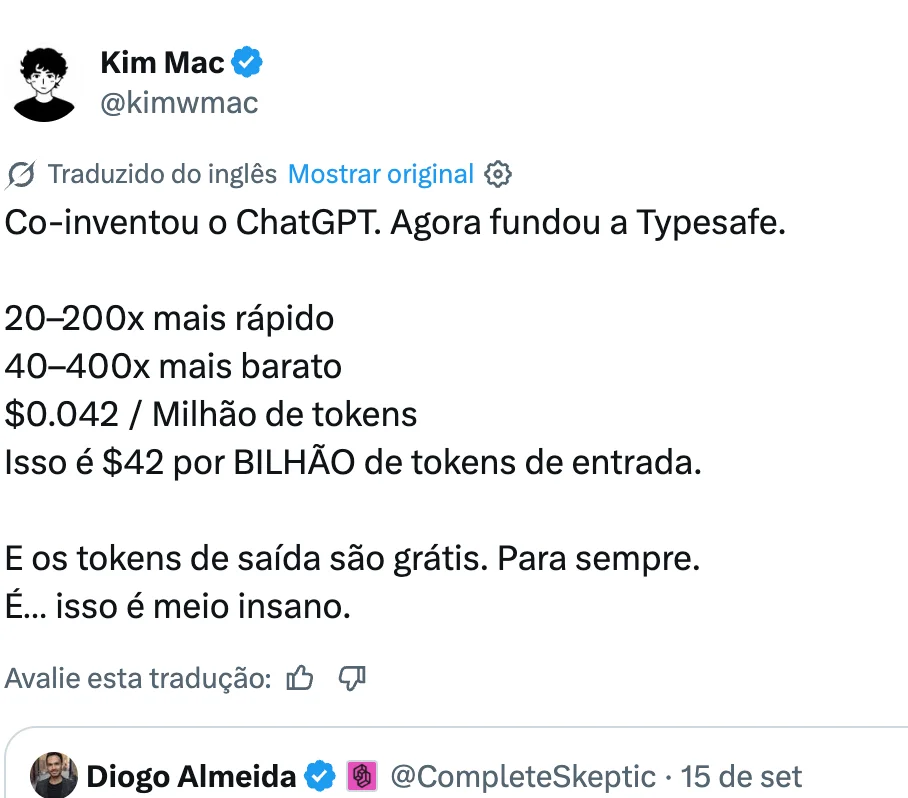
A Kim Mac resumiu os números que o próprio Diogo publicou: de 20 a 200 vezes mais rápido, de 40 a 400 vezes mais barato, US$ 0,042 por milhão de tokens de entrada e saída grátis.
Onde ela entra num lançamento
A regra é simples. Se a tarefa é ler muito texto e tomar a mesma decisão várias vezes, ela serve.
- Triagem de WhatsApp no CRM. Cada mensagem que chega vira: quer comprar, tem dúvida, não quer, pediu pra sair, resposta automática. Hoje muito CRM move o card de qualquer jeito, sem ler.
- Respostas abertas de pesquisa e quiz. Dor, desejo, objeção, nível de consciência. O texto livre que hoje ninguém lê vira coluna que entra no lead scoring.
- Ficha de matrícula. O que motivou a compra e o que precisa acontecer pra valer a pena. Material direto pra próxima copy e pra área de membros.
- Comentários e DMs. Separar elogio, dúvida, objeção e intenção de compra no meio de milhares de comentários de um reel.
- Conferir copy antes de publicar. Pergunta de sim ou não: essa frase promete resultado que a gente não pode prometer? Esse termo está sendo usado no sentido proibido?
- Conferir afirmação contra a fonte. Esse número do roteiro aparece mesmo no documento de onde ele veio?
- Arrumar nome bagunçado. "Método 2.0", "Turma 14) Método 2.0", "Método 2.0 Turma 14". Ela aponta que é o mesmo produto. Eu testei com 115 nomes de produto de um projeto e custou menos de um centavo.
O truque que faz isso funcionar em produção é usar a certeza que ela devolve. Certeza alta, o sistema segue sozinho. Certeza baixa, manda pra alguém do time olhar. Automação que sabe quando pedir ajuda.
Onde ela NÃO entra
Aqui é onde muita gente vai se confundir, então vou ser bem direto.
- Ela não escreve. Copy, resposta de WhatsApp, e-mail, roteiro: continua sendo o Claude ou o ChatGPT.
- Ela não substitui teste A/B. Ela julga o texto de uma CPL. Ela não sabe como o seu público vai reagir. Comportamento real só se mede com gente real.
- Ela não faz conta. Taxa de conversão, ticket médio, churn: isso é fórmula. Mandar número pra ela dar nota é jogar dinheiro fora.
- Ela só lê texto. Imagem, áudio e vídeo não entram. Transcreve antes.
- Ela não aprende sozinha com os seus dados. Ela responde o que você pergunta, do jeito que você perguntou.
- Ela não conserta pesquisa mal feita. Num dos meus testes, comparei leads e alunas usando formulários que faziam perguntas diferentes. Ela classificou tudo certo. A comparação saiu errada. Se as perguntas não são comparáveis, nenhuma IA salva.
E um aviso sobre "não alucina". Formato errado ela não devolve mesmo. Mas a própria documentação diz que resposta no formato certo garante o formato, e não que a resposta esteja certa. No meu teste ela errou alguns nomes de produto. A maioria veio com certeza baixa, o que permitiu separar. Dois vieram com certeza alta. Confere uma amostra antes de ligar no automático.
O prompt pra descobrir onde ela te ajuda
O que eu te indico fazer: lê esta newsletter no detalhe e depois manda ela, junto com a documentação da TypeSafe, pra tua IA. Ela analisa o teu dia a dia e te mostra onde isso faz sentido, principalmente onde você está gastando token de IA grande com decisão que se repete.
Copia e cola no Claude, no ChatGPT ou no Codex:
Lê essa newsletter inteira: [cola o link desta newsletter]
Depois lê a documentação oficial da TypeSafe: https://docs.typesafe.ai/llms.txt
Segue os links que fizerem sentido. Principalmente os exemplos de uso e o preço.

Agora olha o meu dia a dia: [conta o que você faz, as ferramentas que usa, onde recebe muita mensagem, formulário, e-mail ou comentário, e onde já usa IA hoje].

Quero saber onde a TypeSafe me ajudaria de verdade. Principalmente onde eu gasto token de uma IA grande pra tomar a mesma decisão várias vezes: classificar, separar, dar nota, dizer sim ou não.

Me mostra os 3 melhores lugares. Pra cada um:
o que entra, quais perguntas eu faria pra ela, quanto isso custaria por mês com o meu volume, e o que continua com o ChatGPT ou o Claude.

Se algum uso não fizer sentido, fala. Se faltar o meu volume pra fazer a conta, me pergunta antes. Não inventa número.
Pra rodar, cria a conta no console da TypeSafe. A minha veio com 5 dólares de crédito, e o dia inteiro de teste aqui gastou 46 centavos disso.
Pega a melhor ideia que sair dali e roda as primeiras 20 linhas ainda hoje.
Bora testar.