Saiu o Gemini 4 Argon: primeiro em 13 de 19 testes, e quase ninguém pode usar ainda.
O novo modelo de fronteira do Google passa GPT-6 Astra, Fable 5.1 e Opus 5.5 na maior parte da tabela oficial, escreve até 1 milhão de tokens numa resposta e, no lançamento, vai custar o mesmo que o Sonnet 5.5. Cada um dos testes explicado, onde ele perde, quanto custa e quando você vai poder usar.
O Google anunciou hoje o Gemini 4 Argon, o novo modelo de fronteira deles. E a tabela que veio junto é a mais agressiva do ano: de 19 linhas, o Argon fica em primeiro em 13, empata em uma e perde em cinco, contra GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5.
Só que o anúncio tem um porém logo no primeiro parágrafo: por enquanto, ele só está liberado pra um grupo fechado de especialistas em segurança digital. Você e eu ainda não conseguimos usar.
Então vamos por partes: o que ele é, cada teste da tabela explicado em palavras simples, onde ele perde, quanto vai custar e quando deve chegar. Os gráficos foram remontados em português com os números oficiais, e os vídeos mostram a página do anúncio traduzida.
O que é o Gemini 4 Argon
Nas palavras do Google, é um modelo feito pra sustentar raciocínio profundo em fluxos de trabalho longos e complexos. As três frentes que eles destacam são engenharia de software do mundo real, trabalho de conhecimento de empresa, como jurídico e financeiro, e defesa em cibersegurança. Quem assina o anúncio é o Koray Kavukcuoglu, vice-presidente sênior do Google DeepMind e arquiteto-chefe de IA do Google.
A novidade técnica mais chamativa é o limite de resposta. O Argon consegue gerar até 1 milhão de tokens numa resposta só, contra 64 mil do limite anterior. Não é a memória de entrada, é quanto ele consegue escrever de uma vez. Na prática, isso deixa ele pensar e produzir centenas de milhares de tokens numa única tarefa longa, sem precisar quebrar em pedaços.
E tem um detalhe curioso sobre o nome. Nas últimas semanas, o Argon já aparecia em vídeos de vazamento no YouTube como um suposto Gemini 4 Pro, com números que não bateram com o anúncio: um deles falava em 10 milhões de contexto e 256 mil de saída. O oficial é 1 milhão de saída, e a janela de entrada o Google não divulgou. Rumor é rumor até a empresa falar.
A tabela inteira, traduzida
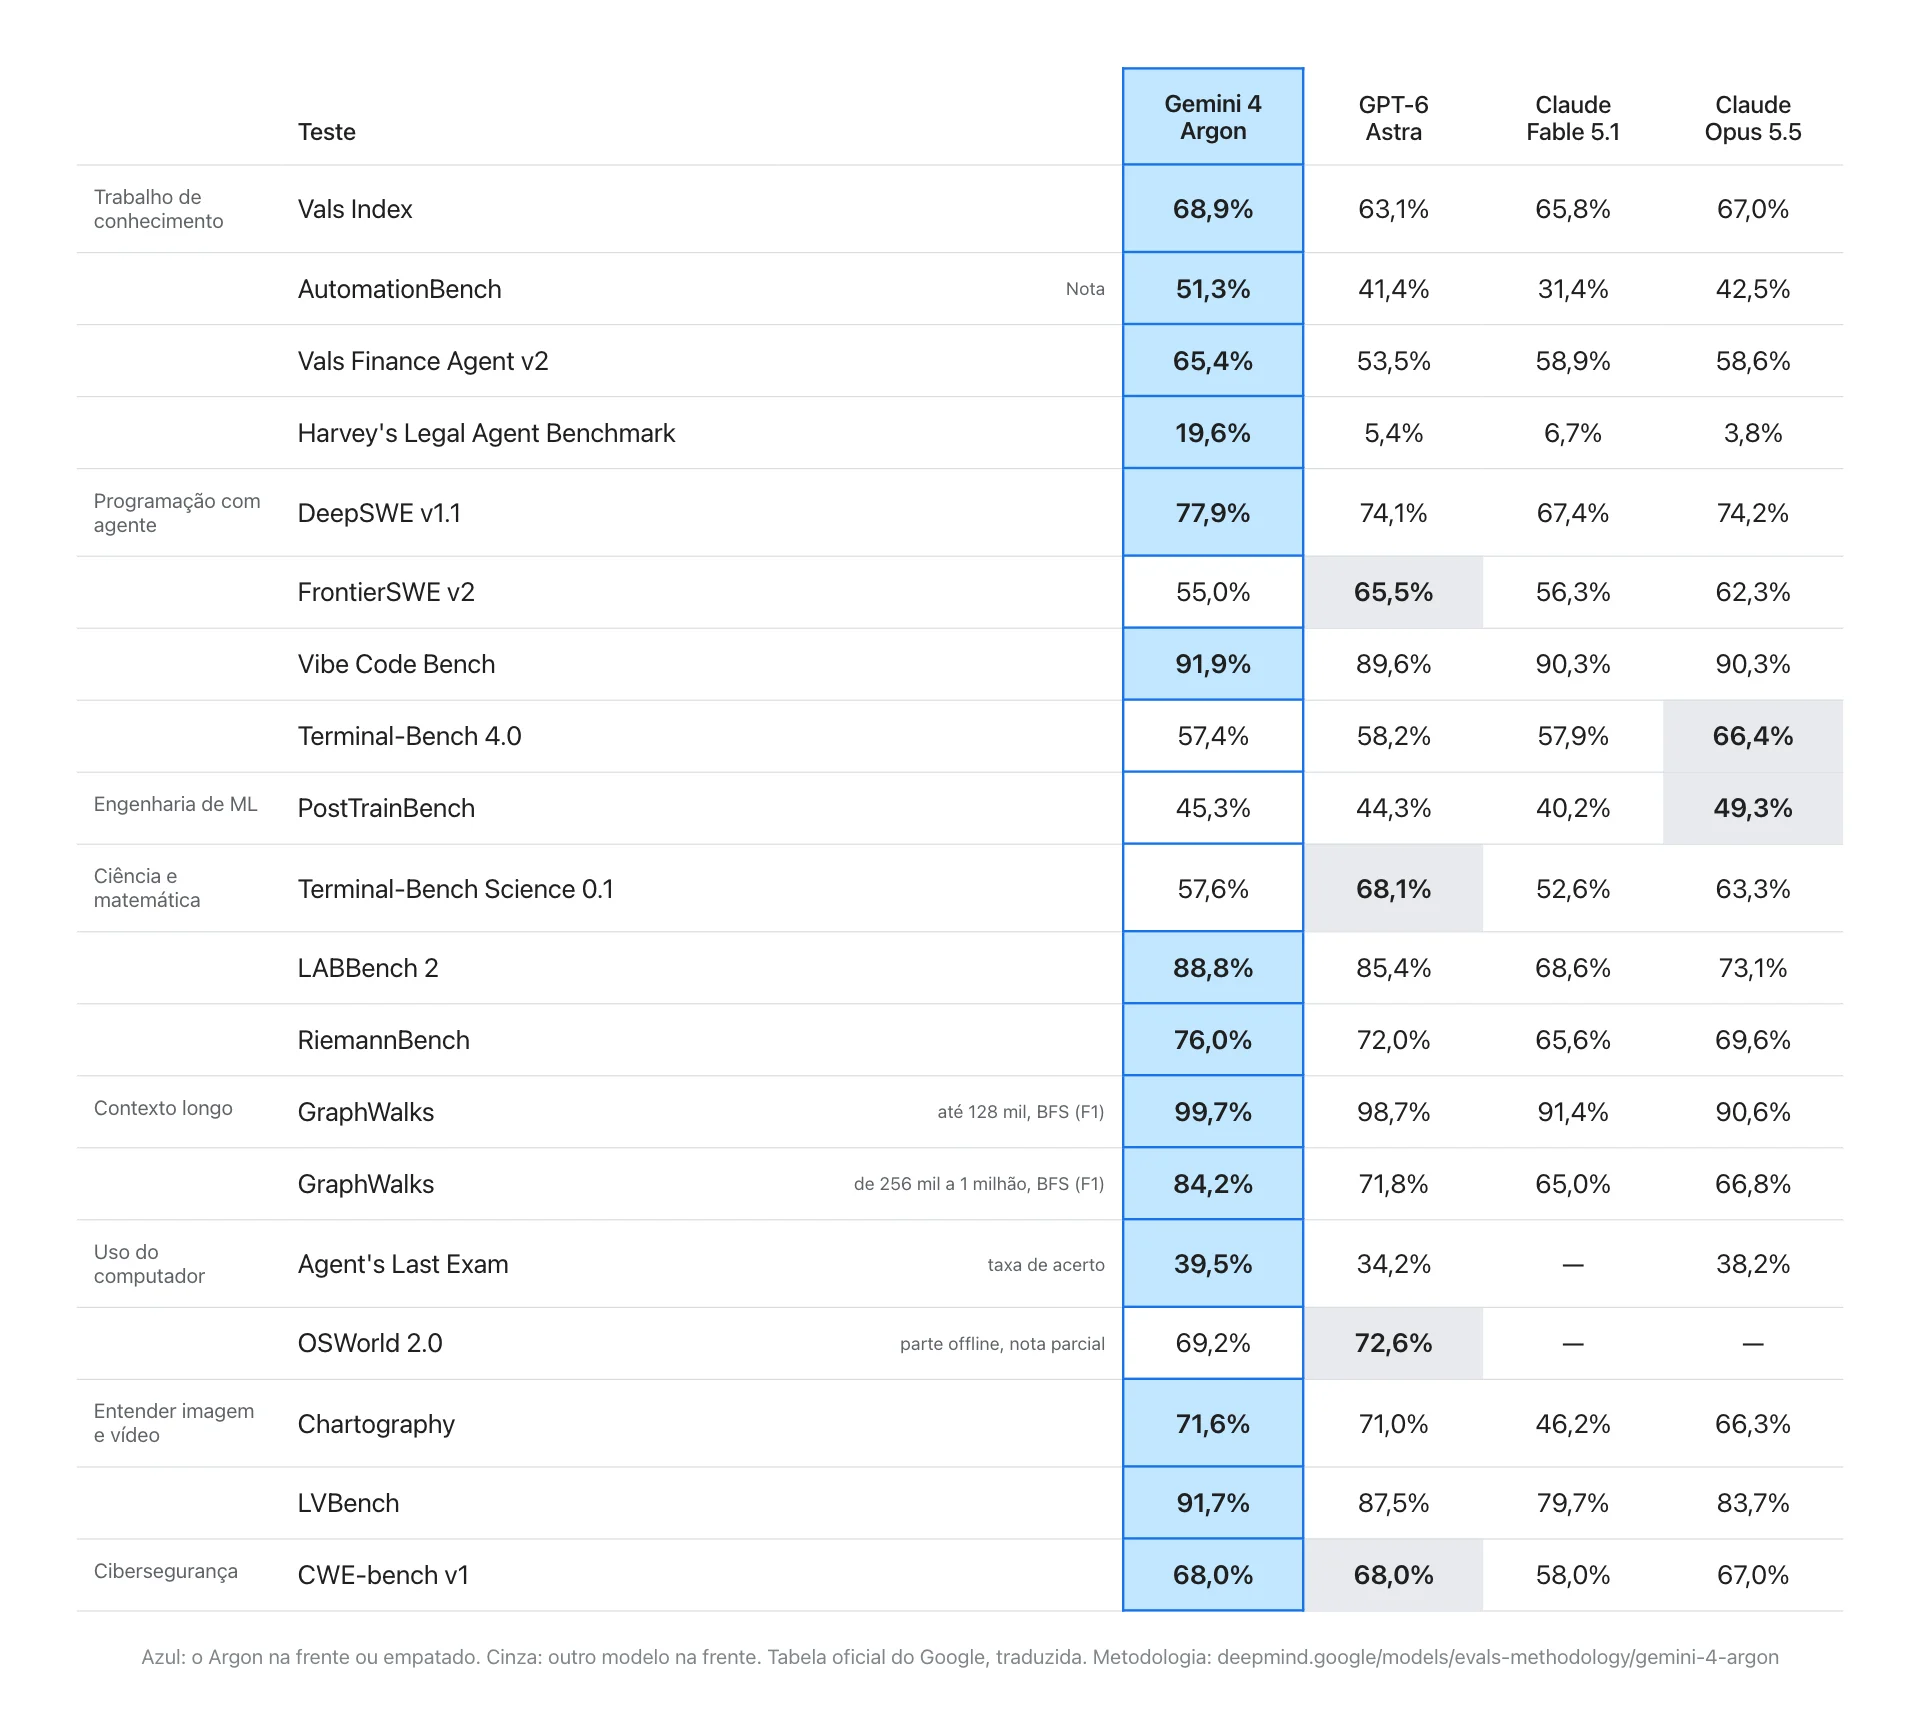
Antes de ir teste por teste, um aviso que vale pra tabela inteira. Todos esses números são do Google, rodados do jeito do Google, com a metodologia publicada. E os números dos concorrentes às vezes não batem com os que as próprias empresas divulgam: no AutomationBench, o Google mostra o Opus 5.5 com 42,5%, e a Anthropic, na página do Opus, mostra 40,0%. Dá pra usar como pista, não como placar.
Trabalho de conhecimento: onde ele abriu mais vantagem
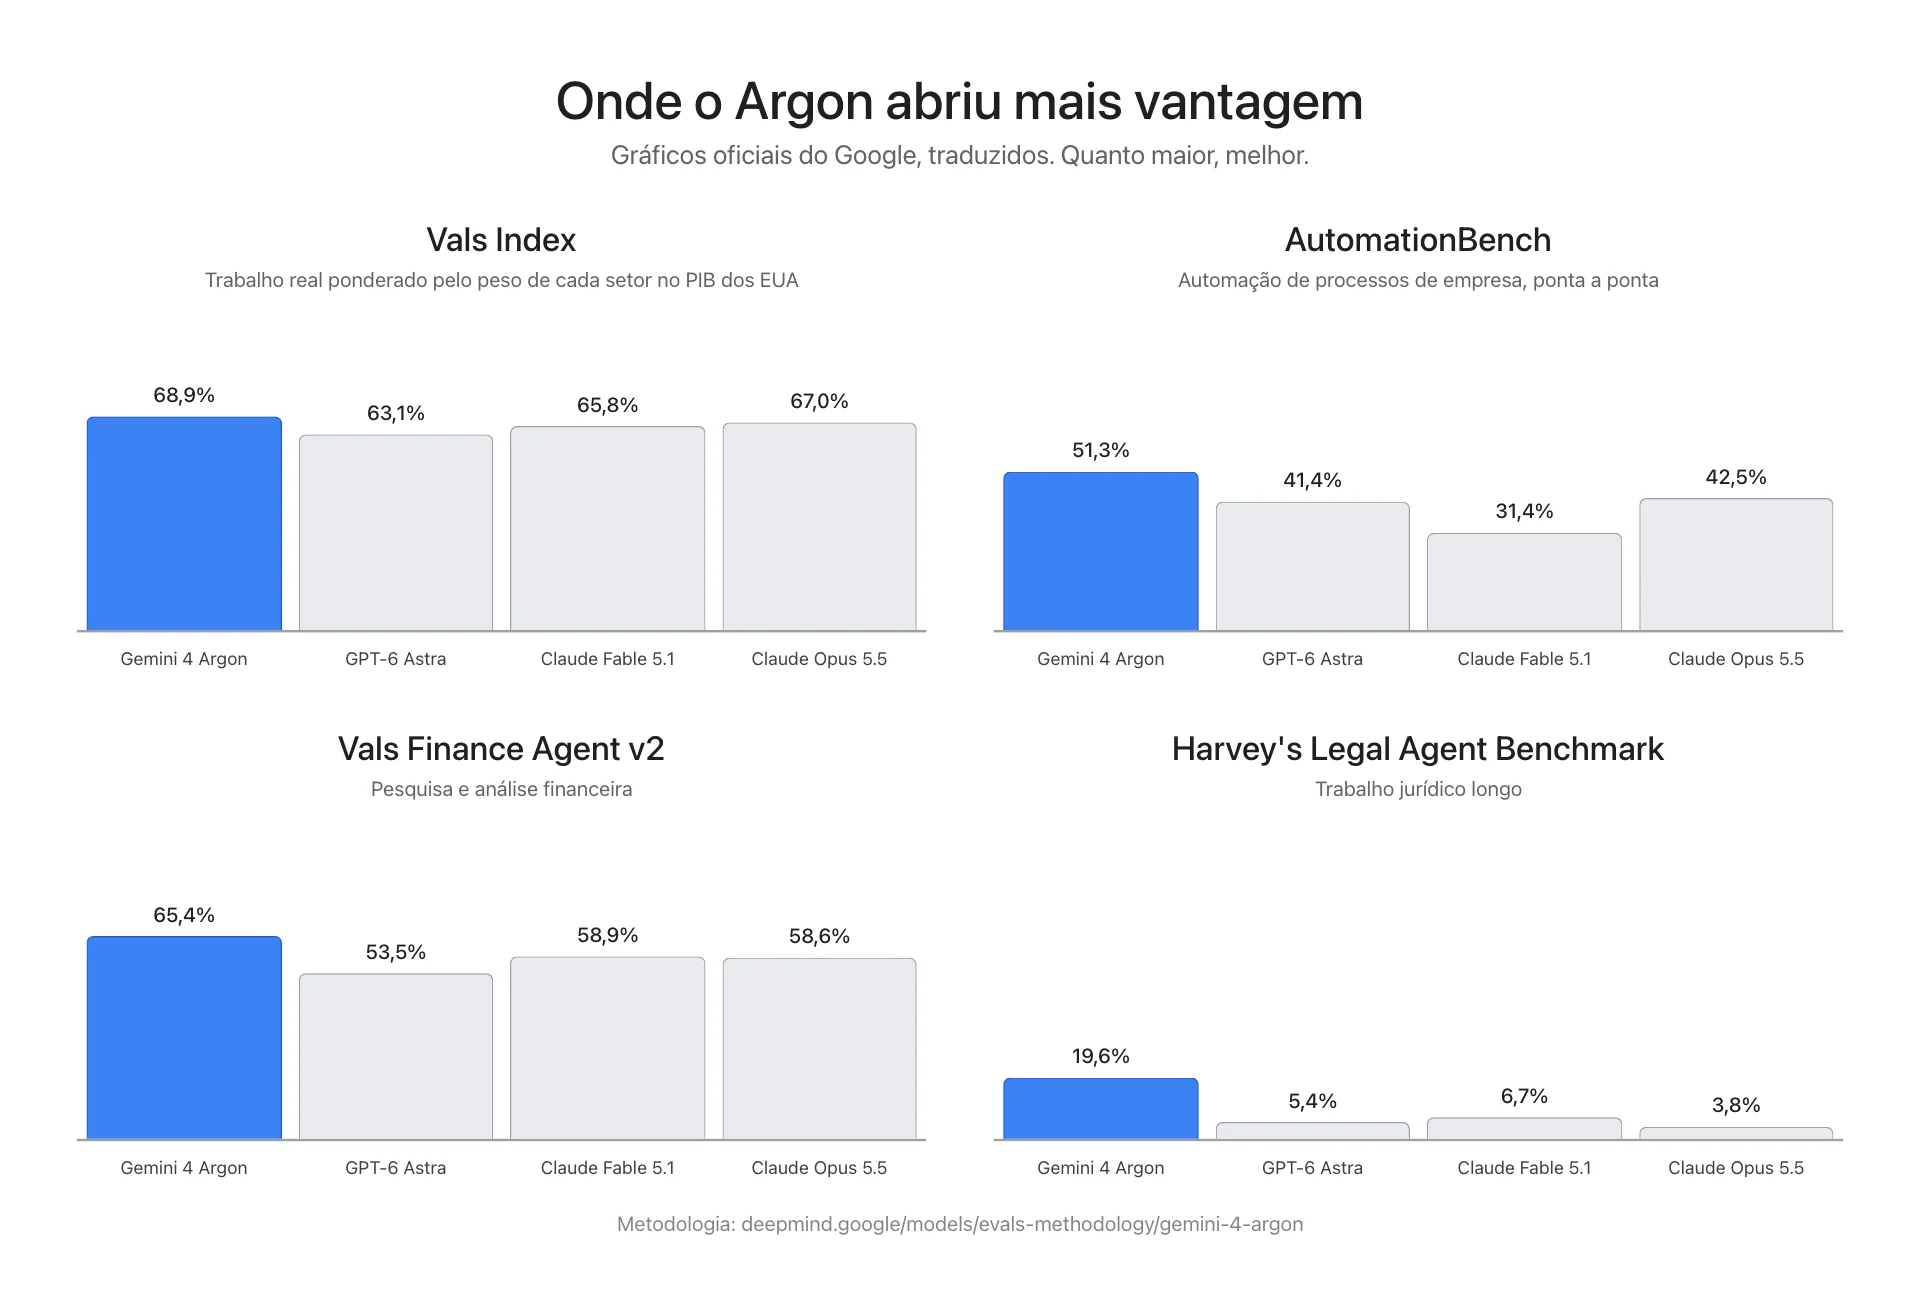
- Vals Index: 68,9%. Mede trabalho de verdade em finanças, programação, jurídico e impostos, com cada setor pesando conforme o tamanho dele no PIB dos Estados Unidos. Opus 5.5 fez 67,0%, Fable 5.1 65,8% e Astra 63,1%. É a vitória mais apertada da tabela: 1,9 ponto na frente do Opus.
- AutomationBench: 51,3%. É o teste da Zapier que mede fluxo de empresa de ponta a ponta, nas áreas principais de um negócio. Opus 5.5 fez 42,5%, Astra 41,4% e Fable 5.1 31,4%. São quase 9 pontos de vantagem, e pra quem vive de automação é o número que mais interessa.
- Vals Finance Agent v2: 65,4%. Pesquisa financeira em várias etapas. Fable 5.1 fez 58,9%, Opus 5.5 58,6% e Astra 53,5%.
- Harvey's Legal Agent Benchmark: 19,6%. Pesquisa e redação jurídica longa. Fable 5.1 fez 6,7%, Astra 5,4% e Opus 5.5 3,8%. A nota é baixa pra todo mundo, mas o Argon faz quase três vezes o segundo colocado.
Uma curiosidade no teste jurídico: o Grok 4.7, da xAI, também aparecia com 19,6% nesse mesmo teste, na tabela que a xAI publicou em 21/09. O Google não colocou o Grok na comparação dele.
Programação: vitórias e duas derrotas
- DeepSWE v1.1: 77,9%. Engenharia de software longa, com tarefas do mundo real. Opus 5.5 fez 74,2%, Astra 74,1% e Fable 5.1 67,4%. O Google chama de novo recorde.
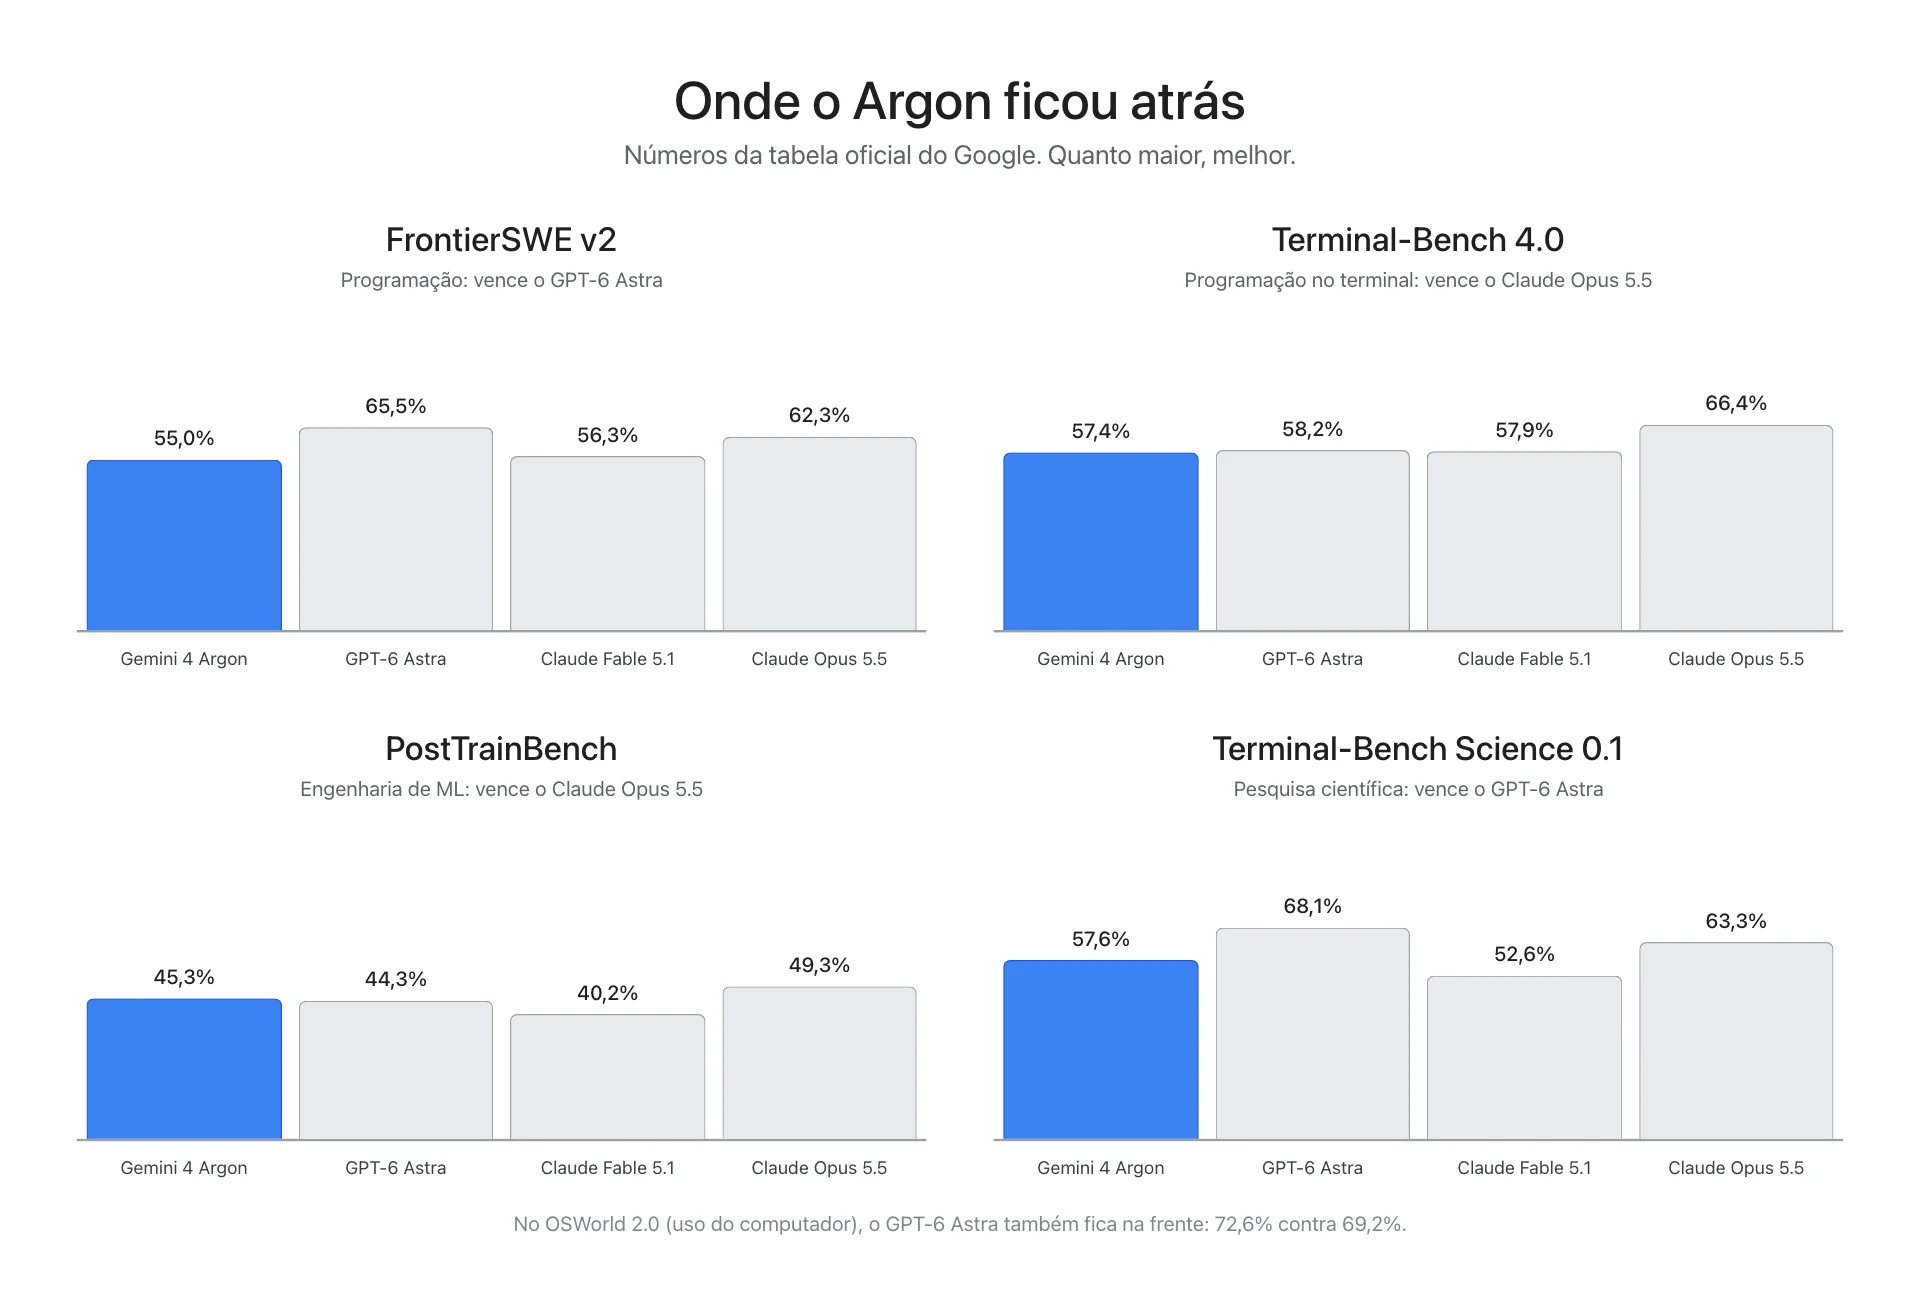
- FrontierSWE v2: 55,0%. Aqui ele perde feio e fica em último: Astra 65,5%, Opus 5.5 62,3% e Fable 5.1 56,3%.
- Vibe Code Bench: 91,9%. O anúncio não explica esse teste, e a diferença é pequena: Fable 5.1 e Opus 5.5 fizeram 90,3%, e o Astra 89,6%.
- Terminal-Bench 4.0: 57,4%. Programação no terminal. Aqui quem ganha com folga é o Opus 5.5, com 66,4%, o mesmo número que a Anthropic publica. O Astra fez 58,2% e o Fable 5.1 57,9%. E o Sonnet 5.5, que saiu dois dias atrás e não está na tabela do Google, fez 70,6% nesse teste, segundo a Anthropic.
- PostTrainBench: 45,3%. Engenharia de machine learning. Outra do Opus 5.5, com 49,3%. Astra fez 44,3% e Fable 5.1 40,2%.
Ciência e matemática
- Terminal-Bench Science 0.1: 57,6%. Pesquisa científica feita por agente. É a maior derrota da tabela: o Astra fez 68,1% e o Opus 5.5 63,3%. Fable 5.1 ficou com 52,6%.
- LABBench 2: 88,8%. Pesquisa de laboratório em biologia. Astra fez 85,4%, Opus 5.5 73,1% e Fable 5.1 68,6%.
- RiemannBench: 76,0%. Matemática. Astra fez 72,0%, Opus 5.5 69,6% e Fable 5.1 65,6%.
Contexto longo: onde a diferença cresce
O GraphWalks cola um mapa gigante de conexões dentro do pedido e manda o modelo percorrer os caminhos certos. É um jeito de medir se ele continua acertando quando o material é enorme.
- Até 128 mil tokens: 99,7%. Astra fez 98,7%, Fable 5.1 91,4% e Opus 5.5 90,6%. Todo mundo vai bem.
- De 256 mil a 1 milhão de tokens: 84,2%. Aqui a distância aparece: Astra 71,8%, Opus 5.5 66,8% e Fable 5.1 65,0%. Com material muito longo, o Argon segura bem melhor.
Uso do computador
- Agent's Last Exam: 39,5% de acerto. O Opus 5.5 fez 38,2% e o Astra 34,2%. O Fable 5.1 ficou sem nota.
- OSWorld 2.0: 69,2%, na parte offline e com nota parcial. Aqui o Astra ganha, com 72,6%, e os dois Claude ficaram sem nota na tabela do Google. A Anthropic publica 81,8% pro Opus 5.5 no OSWorld 2.1, que é outra versão do teste, então não dá pra comparar direto.
Imagem e vídeo
- Chartography: 71,6%. Leitura de gráficos. Astra fez 71,0%, Opus 5.5 66,3% e Fable 5.1 46,2%. Cada empresa roda esse teste com ou sem ferramentas, e o número muda bastante de uma página pra outra.
- LVBench: 91,7%. Entender vídeo longo. Astra fez 87,5%, Opus 5.5 83,7% e Fable 5.1 79,7%. O Google diz que é o melhor resultado já registrado nesse teste.
Cibersegurança: o foco do lançamento
Esse é o motivo de o Argon estar saindo primeiro pra especialistas em segurança. O Google treinou ele pra achar, confirmar e corrigir falhas graves de software sozinho.
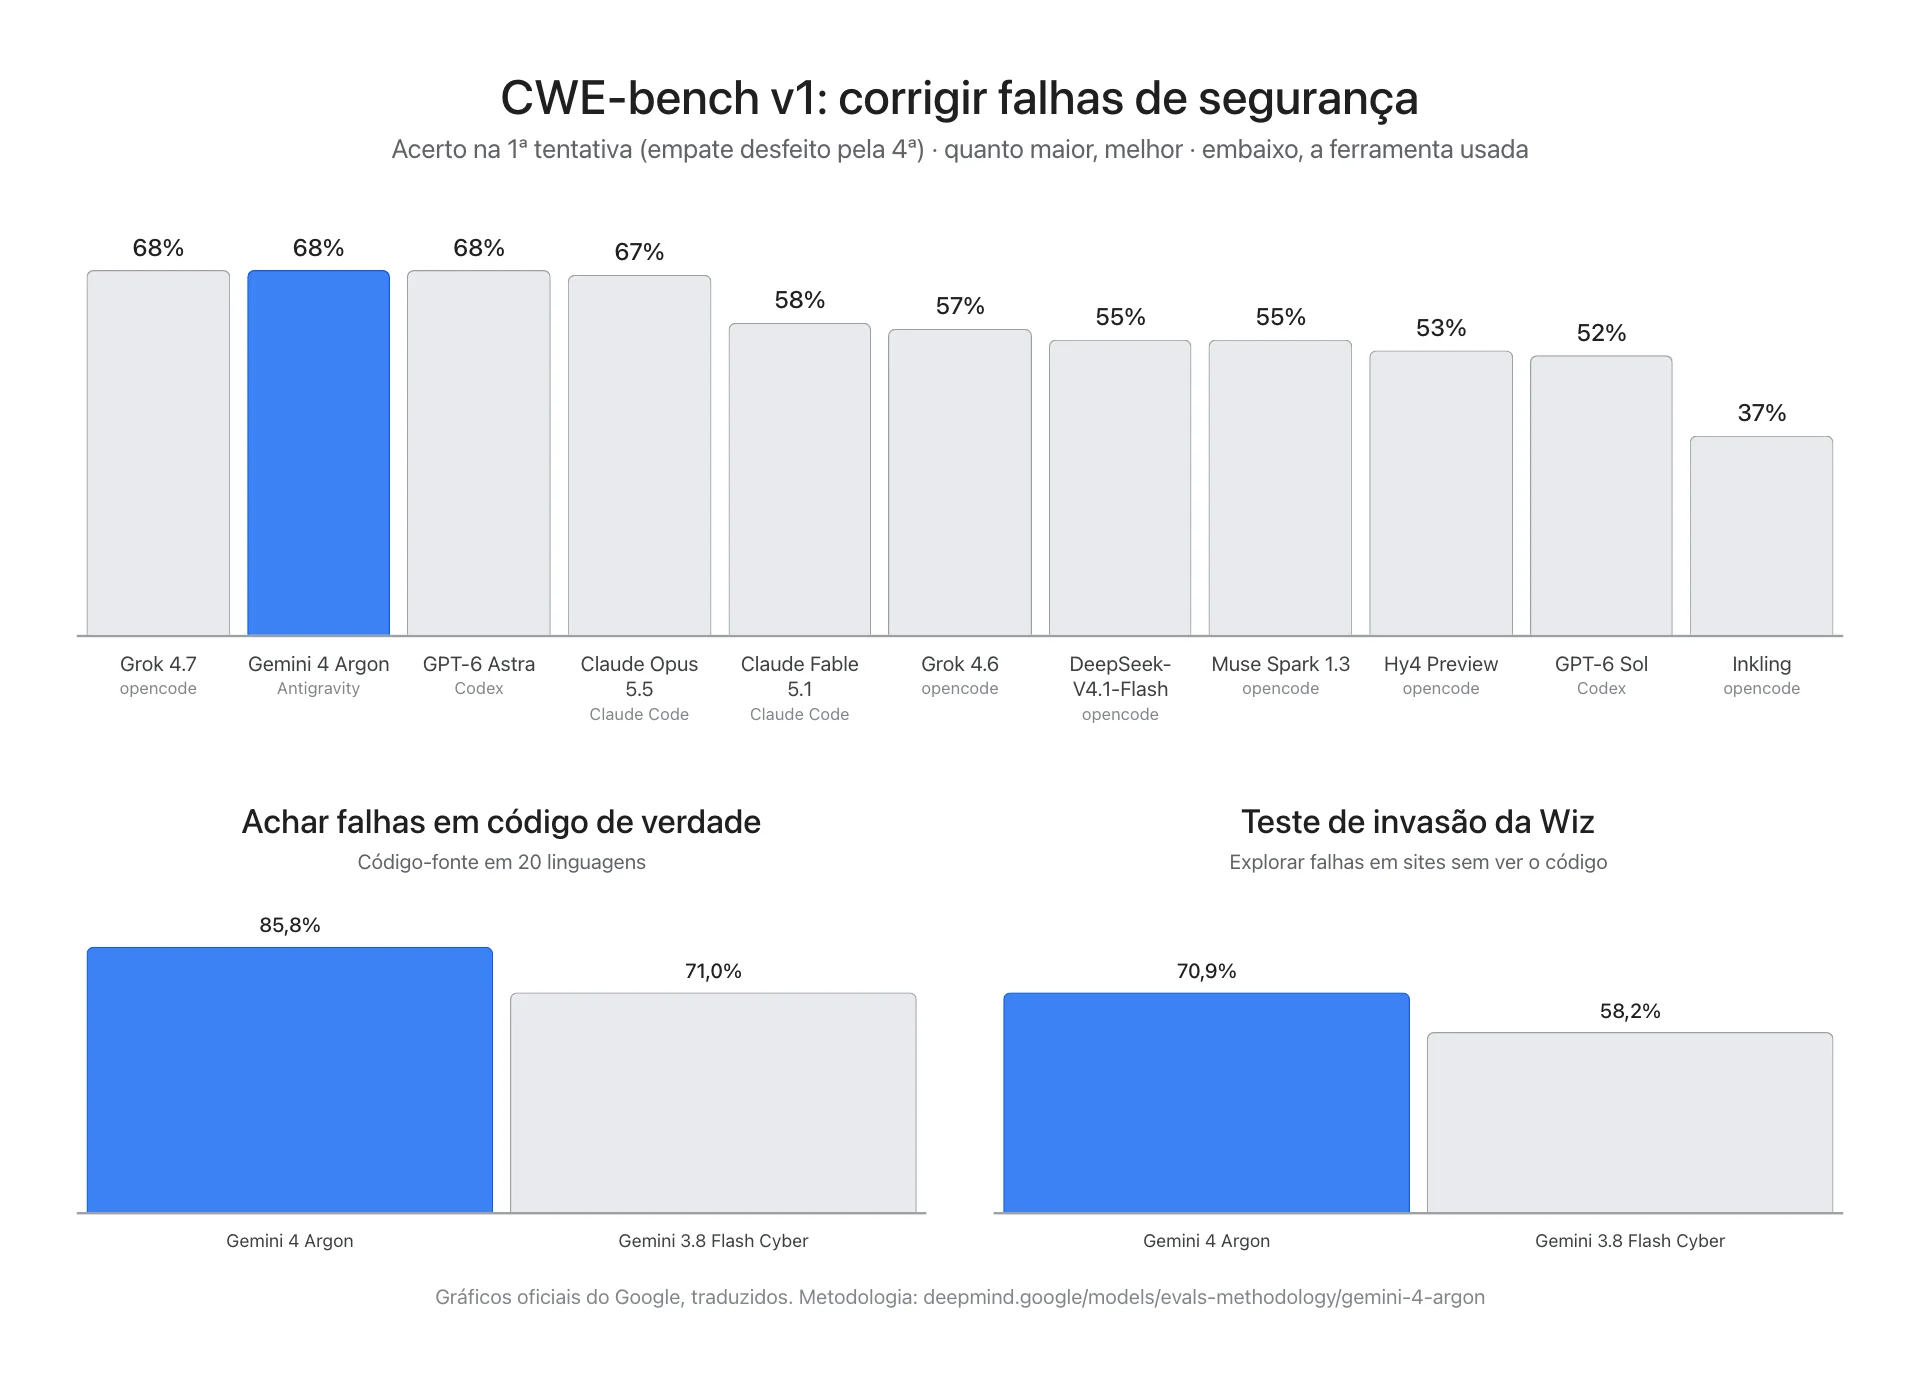
- CWE-bench v1: 68%. Mede se o modelo corrige falhas de segurança. É empate triplo com o Grok 4.7 e o GPT-6 Astra, com o Opus 5.5 logo atrás, com 67%. Repara que cada um rodou na ferramenta da própria casa: o Argon no Antigravity, o Astra no Codex e os Claude no Claude Code.
- Achar falhas em código de verdade: 85,8%, varrendo código-fonte em 20 linguagens, contra 71,0% do Gemini 3.8 Flash Cyber, o modelo anterior do Google pra segurança.
- Teste de invasão da Wiz: 70,9%, explorando sites sem ver o código, contra 58,2% do modelo anterior.
O exemplo que eles contam: a Wiz, que já usa o Argon num programa gratuito de proteção de infraestrutura pública, achou uma falha grave que expunha dados pessoais em softwares de saúde usados por hospitais no mundo todo. Segundo o Google, os modelos de fronteira anteriores tinham deixado passar.
E um ponto que chama atenção: pros defensores confiáveis e pros times internos do Google, o Argon vai sair sem as travas de cibersegurança, pra eles usarem a capacidade inteira.
Comando escondido: o teste que mais importa pra quem usa agente
Prompt injection é quando alguém esconde uma instrução maliciosa num site, num e-mail ou num documento, e o agente lê aquilo e obedece. Pra quem deixa IA navegando e agindo sozinha, é o risco número um.
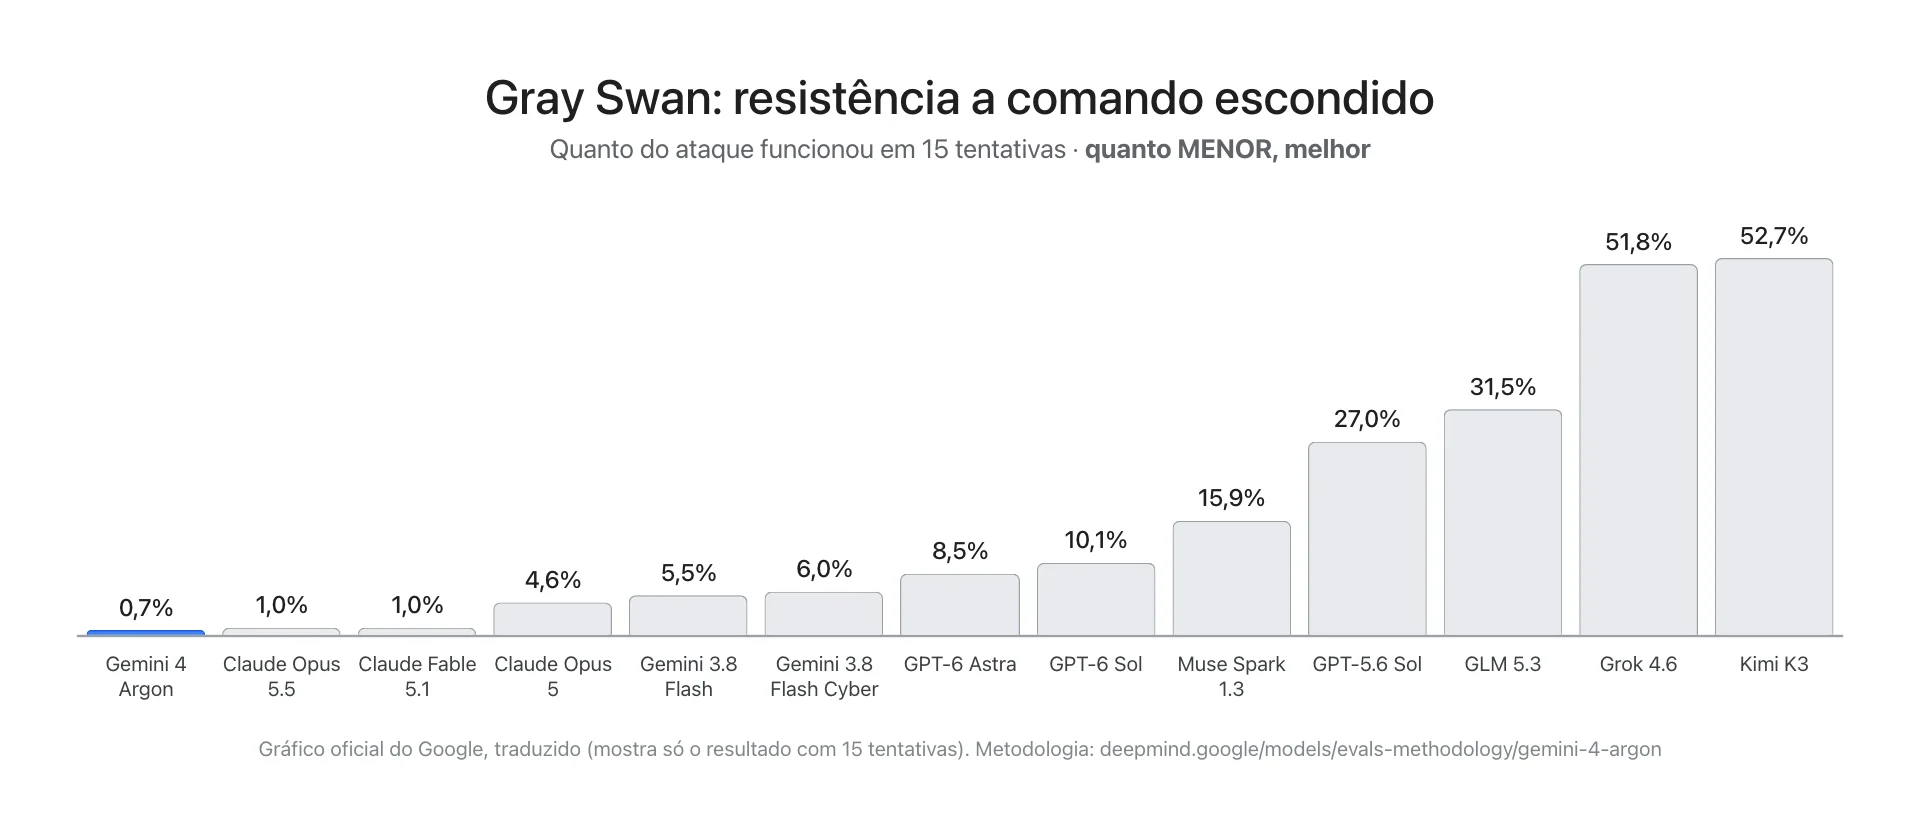
No teste da Gray Swan, depois de 15 tentativas, o ataque funcionou em 0,7% das vezes contra o Argon. O Opus 5.5 e o Fable 5.1 ficaram em 1,0%, o GPT-6 Astra em 8,5% e o GPT-6 Sol em 10,1%. Aqui os Claude ficam praticamente empatados com o Argon, e os modelos da OpenAI bem atrás.
Além disso, o Google lista quatro frentes de segurança antes de liberar pra todo mundo: bloquear uso pra ataque digital e armas químicas, biológicas, radiológicas e nucleares, resistir a comando escondido, vigiar o raciocínio do modelo pra parar a execução se ele sair do que o usuário pediu, e isolar os ambientes de teste.
O que o Google já faz com ele por dentro
Segundo o anúncio, milhares de funcionários do Google já usam o Argon, principalmente em código especializado, pesquisa mais profunda e qualidade de escrita. Os exemplos que eles deram:
- Computação quântica: superou em 40% a melhor marca publicada numa otimização, em questão de minutos.
- Memória dos data centers: um time de agentes Argon achou e aplicou otimizações que liberaram mais de 300 TiB de memória, com economia total estimada entre 500 TiB e 1 PiB.
- Migração de código: agentes estão levando bases em C e C++ pra Rust, de dezenas de milhares de linhas até mais de 800 mil, no núcleo do sistema Fuchsia.
- Decodificador de vídeo: no libgav1, substituíram 32 mil linhas de código e o resultado ficou 2,7 vezes mais rápido que a versão anterior em Rust, com o vídeo saindo idêntico.
Quanto vai custar
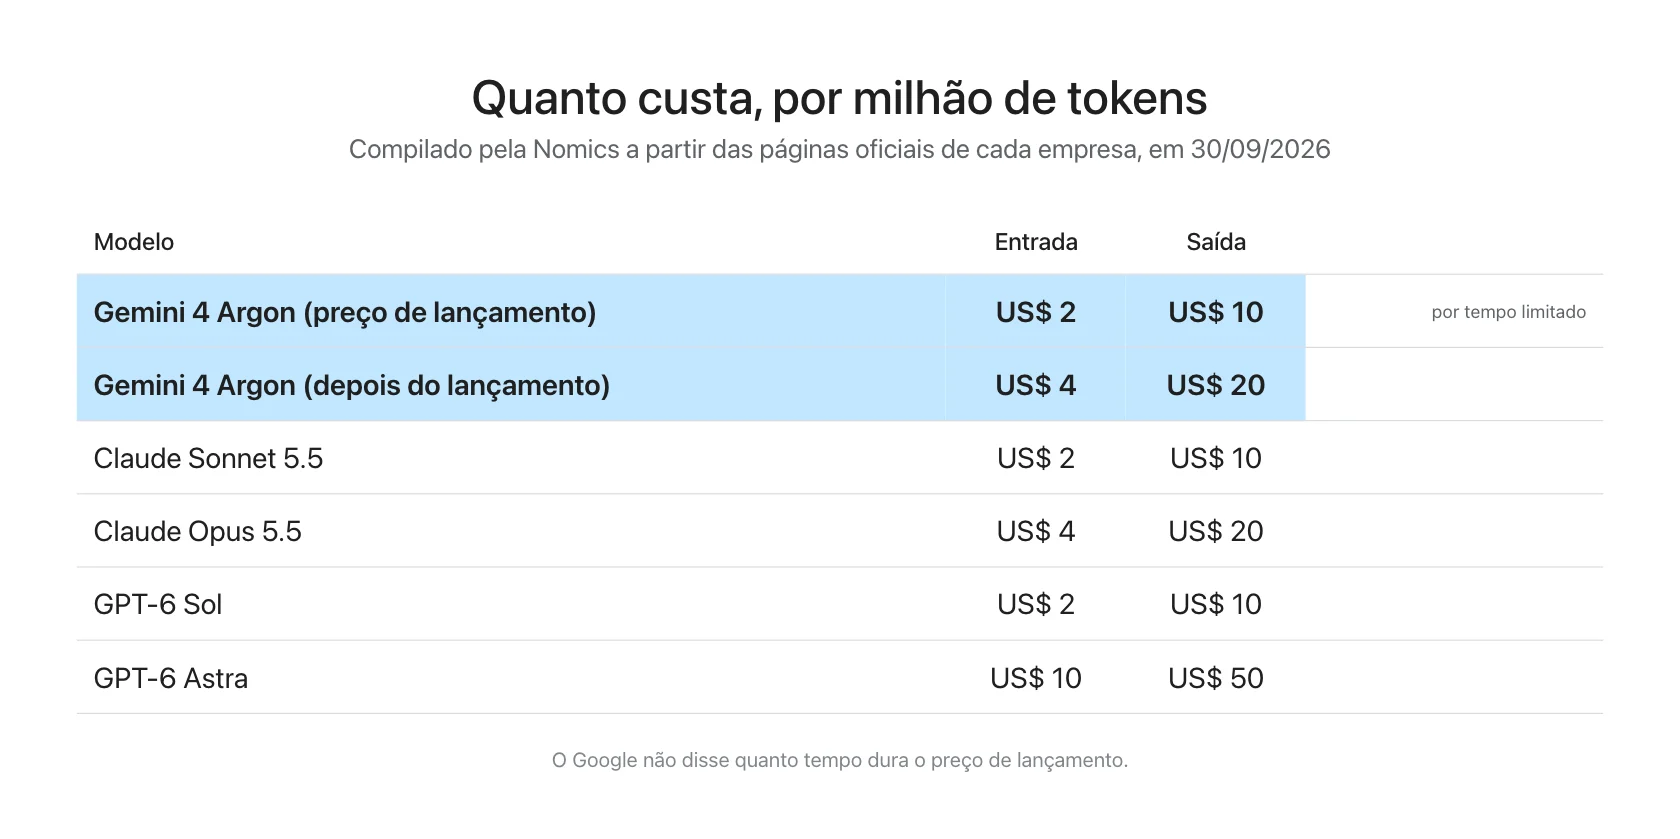
No lançamento, o Argon vai custar US$ 2 na entrada e US$ 10 na saída por milhão de tokens, e a entrada em cache sai com 95% de desconto. Depois do período de lançamento, sobe pra US$ 4 e US$ 20, segundo a nota de rodapé do anúncio.
Coloca isso do lado do que você já usa. No lançamento, o Argon custa o mesmo que o Sonnet 5.5 e o GPT-6 Sol. Depois, custa o mesmo que o Opus 5.5. E fica bem abaixo do GPT-6 Astra, que cobra US$ 10 e US$ 50. O Google não disse quanto tempo dura o preço de lançamento.
Quando você vai poder usar
Agora, só pelo Fairwind Program, que dá prioridade a governos, operadores de infraestrutura crítica (saúde, telecomunicações, energia e redes financeiras) e grandes plataformas de tecnologia. Quem entra passa por checagem de antecedentes e aceita usar o modelo só pra defesa. O Google também está participando do processo voluntário do governo dos Estados Unidos de acesso antes do lançamento.
Depois, a ordem que eles deram é: primeiro clientes pagos da API e assinantes do Google AI Ultra, e depois desenvolvedores, empresas e consumidores em geral. Data, nenhuma.
O que muda pra quem usa IA no trabalho
Hoje, nada muda no seu fluxo, porque você não consegue usar o Argon. O Opus 5.5 e o Sonnet 5.5 continuam sendo o que eu uso aqui na Nomics, e na própria tabela do Google o Opus ainda ganha na programação no terminal.
Quando ele abrir, eu olharia três coisas primeiro. A automação, porque os quase 9 pontos no AutomationBench são a maior vantagem dele em trabalho de empresa. Os documentos muito longos, onde o contexto longo dele segura bem melhor. E o preço de lançamento, que coloca um modelo desse nível no preço do Sonnet enquanto durar.
Onde eu seguraria a empolgação
Todos os números são do Google, e os dos concorrentes foram rodados pelo Google, às vezes com resultado diferente do que as próprias empresas publicam. O Argon perde em cinco testes, incluindo programação no terminal e pesquisa científica. O acesso está fechado e sem data, e o preço de lançamento não tem prazo. E ninguém fora do grupo de testadores conseguiu usar ainda, então por enquanto é a palavra do Google.
Pra acompanhar
- O anúncio completo: blog.google, Gemini 4 Argon
- A metodologia de cada teste: deepmind.google/models/evals-methodology/gemini-4-argon
- O programa de acesso antecipado: deepmind.google/fairwind-program